La normalizzazione dei dati cross asset è un contratto che garantisce nomi dei campi, tipi e timestamp identici tra venue e asset class diverse, a prescindere da dove provengano i dati grezzi. Prima di ogni altra cosa, occorre imporre uno schema canonico e uniformare ogni timestamp in ISO-8601 UTC. Da lì in poi, si applicano scaler standard come Z-score o RobustScaler, a seconda della distribuzione di ciascuna feature.
In breve:
- La normalizzazione dovrebbe avvenire a monte (upstream) per evitare la duplicazione del lavoro di manutenzione degli adapter e garantire un'elaborazione dei dati coerente e verificabile su tutte le asset class.
- Una corretta mappatura dello schema deve affrontare trappole comuni come conversioni valutarie implicite, numeri sotto forma di stringhe, prezzi negativi e schema drift, che possono causare errori subdoli.
- I metodi di scaling migliori dipendono dalla distribuzione della feature: Z-score per serie simmetriche, RobustScaler in presenza di outlier e Min-Max per input con limiti definiti, applicati all'interno di finestre mobili nel caso di dati intraday.
- Validare la normalizzazione richiede sia test unitari che di integrazione, un monitoraggio statistico continuo e una documentazione dettagliata e sotto controllo di versione ai fini di audit e compliance.
- Utilizzare dati già pre-elaborati, come le minute bar pulite di BacktestMarket, consente un'integrazione più rapida e affidabile nei modelli di trading, riducendo il rischio di errori di schema e di timestamp.
Indice
- Cosa deve garantire uno schema normalizzato
- Una pipeline di normalizzazione pratica per dati multi-asset
- Scegliere lo scaler giusto per ogni feature
- Normalizzazione upstream vs downstream
- Esempi di schema canonico e trappole comuni nella mappatura
- Test e monitor per individuare regressioni nella normalizzazione
- Come BacktestMarket riduce il lavoro di normalizzazione
- Cosa significa la normalizzazione per l'analisi di portafoglio e il rischio
- Strumenti e piattaforme per costruire pipeline di normalizzazione
- Cosa mostrano i deployment reali sulla normalizzazione
- Governance e compliance nella normalizzazione cross-asset
- Errori comuni degli sviluppatori con la normalizzazione
- Dove si inserisce BacktestMarket nel tuo progetto di normalizzazione
- Fonti
- FAQ
Cosa deve garantire uno schema normalizzato
Un feed normalizzato è una promessa tra il fornitore dei dati e ogni consumatore a valle: un modello, un backtester, un motore di rischio. Questa promessa si articola su cinque livelli, e saltarne anche solo uno crea una classe specifica e prevedibile di bug. Una panoramica orientata agli sviluppatori sui dati di mercato normalizzati descrive questi livelli come il contratto fondamentale di cui ogni schema pulito ha bisogno.
- Denominazione dei campi: un nome per concetto (
close, maic,Closeelast_pxin feed diversi). - Coerenza dei tipi: i prezzi sono float, non stringhe che a volte arrivano tra virgolette da un export CSV.
- Formato dei timestamp: ogni timestamp è in ISO-8601 UTC, il che elimina i bug legati all'ora legale che colpiscono i feed che mescolano orari locali della borsa e orari UTC.
- Busta della risposta (envelope): ogni payload, sia esso ottenuto tramite una chiamata REST o inviato via WebSocket, racchiude i dati nella stessa struttura con gli stessi campi di metadati.
- Gestione dei valori nulli: un valore mancante viene sempre rappresentato allo stesso modo, mai a volte come
null, a volte come0, a volte come stringa vuota.
Allineare i tipi dei campi a qualcosa come la specifica dei tipi di dato FIX aiuta anche in questo, dato che FIX definisce già tipi stringa, prezzo e quantità, con casi limite come il supporto ai prezzi negativi per determinati strumenti già integrato. Considera questa specifica come punto di riferimento quando il tuo registro di mappatura deve decidere quanto debba essere rigoroso un tipo numerico.
Una pipeline di normalizzazione pratica per dati multi-asset
La maggior parte delle pipeline in produzione converge sulla stessa struttura, indipendentemente dal fatto che la fonte sia un file CSV, uno stream JSON via WebSocket o messaggi FIX grezzi.
- Ingestione e validazione: accettare il payload grezzo e verificarne solo la validità strutturale (è JSON parsabile? il CSV ha il numero di colonne previsto?) prima di toccare la logica di business.
- Parsing e mappatura: far passare il payload attraverso un registro di mappatura specifico per vendor e per asset class, che traduce i nomi dei campi del vendor in quelli canonici.
- Coercizione dei tipi ed enforcement dello schema: convertire le stringhe in float, validare gli enum (lato dell'ordine, asset class) e rifiutare senza esitazioni tutto ciò che non rispetta lo schema canonico.
- Armonizzazione dei timestamp e resampling: convertire ogni timestamp in ISO-8601 UTC, quindi applicare la regola di resampling: le barre intraday si aggregano su finestre fisse, mentre le barre giornaliere si allineano alla chiusura della borsa.
- Gestione degli outlier, scaling, arricchimento e archiviazione: segnalare o tagliare i valori estremi, applicare lo scaler appropriato per ogni serie, allegare i metadati (venue, storico degli adjustment), poi scrivere nel tuo archivio canonico.
Consiglio pratico: tieni il registro di mappatura sotto controllo di versione come dato, non come codice, in modo che l'integrazione di un nuovo vendor sia una pull request contro una tabella e non un redeploy.
Questa struttura di pipeline regge sia che tu stia unificando azioni e FX, sia che tu stia aggiungendo in un secondo momento dati sulle commodity. La nostra guida sui gap dovuti alle festività nei dati di mercato approfondisce i casi limite del resampling legati alle chiusure di borsa.
Scegliere lo scaler giusto per ogni feature
Non tutte le feature numeriche andrebbero scalate allo stesso modo, e la scelta sbagliata degrada silenziosamente le performance del modello molto prima che qualcuno se ne accorga. La guida alla normalizzazione dei dati della Northeastern considera lo Z-score la scelta predefinita per le variabili continue che alimentano modelli lineari, riserva il Min-Max scaling agli input con limiti noti e fissi, e raccomanda RobustScaler ogni volta che gli outlier distorcerebbero altrimenti lo Z-score.
- Z-score (standardizzazione): scelta predefinita per i rendimenti e altre feature continue approssimativamente simmetriche che alimentano modelli lineari o basati sulla distanza.
- Min-Max scaling: ideale per input con limiti definiti, come una feature già vincolata tra 0 e 1, o la profondità normalizzata dell'order book.
- RobustScaler: la scelta giusta ogni volta che una serie presenta outlier significativi, come il volume di trading durante un picco di notizie.
- Trasformazioni logaritmiche e per quantili: i volumi in genere subiscono una trasformazione logaritmica prima dello scaling, poiché il volume grezzo è fortemente asimmetrico verso destra.
La standardizzazione rolling, per singola serie, è la prassi per le finestre intraday, e la stessa guida avverte esplicitamente che calcolare media e deviazione standard sull'intero dataset prima di suddividerlo in finestre di train e test fa trapelare informazioni future nel passato. Bisogna scalare all'interno di ciascuna finestra mobile, per singolo strumento, e ricalcolare quelle statistiche man mano che arrivano nuovi dati, invece di congelarle al momento del training.
Il modulo di preprocessing di scikit-learn offre qui un percorso di implementazione pronto all'uso: le sue classi Normalizer e transformer supportano le norme l1, l2 e max e si inseriscono direttamente in una pipeline, anche per gli input sparsi tipici dei dati di order book.
Normalizzazione upstream versus downstream
Il settore si sta spostando verso una normalizzazione più vicina alla fonte. Un'analisi di Quod Financial sulla normalizzazione upstream descrive come normalizzare al momento della cattura del dato, come fa la sua architettura UNITY, riduca la duplicazione del lavoro sugli adapter e crei una base condivisa che i sistemi di surveillance, reporting ed esecuzione possono utilizzare tutti senza livelli di traduzione su misura.
- La normalizzazione upstream elimina la necessità che ogni team a valle scriva e mantenga il proprio adapter per lo stesso feed grezzo.
- Riduce il rischio operativo, perché un unico livello di normalizzazione, sottoposto ad audit, è più facile da monitorare rispetto a una dozzina di livelli specifici per team.
- La normalizzazione downstream ha ancora un suo spazio negli ambienti di ricerca, dove un team quant che prototipa un nuovo segnale ha bisogno di una rimodellazione rapida e flessibile che un livello upstream condiviso rallenterebbe.
I team che gestiscono strategie in produzione dovrebbero spingere verso il modello upstream; i team che stanno ancora esplorando idee possono continuare a normalizzare downstream ancora per un po'.
Esempi di schema canonico e trappole comuni nella mappatura
Uno schema canonico minimo per le candele richiede solo una manciata di campi: symbol (stringa), ts (stringa ISO-8601 UTC), open, high, low, close (float), volume (float o intero a seconda dell'asset class), venue (stringa) e via (il feed o l'adapter specifico che ha prodotto il record). Mappare il campo UTCTimestamp di un vendor su ts e un ticker specifico della venue come EURUSD.FX1 su un symbol canonico sono le due trasformazioni più comuni eseguite da qualsiasi adapter.
Le trappole che rompono queste mappature in produzione sono ben documentate e ricorrono tra i vari vendor:
- Conversione valutaria implicita (vehicle-currency): una nota del progetto market-data-normalizer avverte che un percorso di conversione non dichiarato può moltiplicare silenziosamente spread e staleness, e che i rendimenti convertiti non sono un semplice aggiustamento additivo: devono essere scomposti correttamente.
- Prezzi negativi: alcuni strumenti, e alcuni prodotti supportati da FIX, trattano legittimamente in territorio negativo, quindi una validazione ingenua del tipo "rifiuta se negativo" rompe dati reali.
- Numeri sotto forma di stringa: un prezzo che arriva come
"1.2345"invece che come float supera un controllo ingenuo sui null ma fa fallire silenziosamente i calcoli a valle. - Semantica del volume mancante: un volume pari a zero e un volume mancante significano cose diverse e non dovrebbero mai collassare sullo stesso valore.
- Schema drift: un vendor aggiunge un campo o ne rinomina uno senza preavviso, e un registro di mappatura non monitorato continua a funzionare finché non produce silenziosamente output errati.
Test e monitor per individuare regressioni nella normalizzazione
La validazione deve avvenire su due livelli: prima che il codice venga rilasciato, e continuamente una volta che è in produzione.
- Test unitari su ogni adapter e tabella di mappatura, verificando che i payload noti dei vendor si mappino esattamente sul record canonico atteso.
- Test di integrazione che eseguono un passaggio completo da grezzo a canonico e verificano che l'output corrisponda allo schema canonico, campo per campo.
- Monitor statistici che osservano la deriva di media e deviazione standard, l'aumento dei tassi di null, i tassi di tick duplicati e i feed che diventano stale oltre una finestra attesa.
- Audit operativi che riconciliano i totali di volume giornalieri con la borsa, controllando in particolare i calendari delle festività e i passaggi all'ora legale, poiché sono le due condizioni più probabili a disallineare silenziosamente i timestamp.
Consiglio pratico: esegui i controlli su ora legale e calendario delle festività come job pianificato a sé stante, separato dai test di schema di routine, poiché emergono solo poche volte all'anno e altrimenti vengono dimenticati.
Come BacktestMarket riduce il lavoro di normalizzazione
BacktestMarket fornisce dati intraday puliti in minute bar su forex, metalli, obbligazioni, indici azionari e commodity, già formattati per l'importazione diretta in MT4 e MT5. Timestamp coerenti e adjustment documentati significano meno manutenzione degli adapter, e il supporto arriva direttamente dagli ingegneri che raccolgono i dati, non da un help desk generico.
Cosa significa la normalizzazione per l'analisi di portafoglio e il rischio
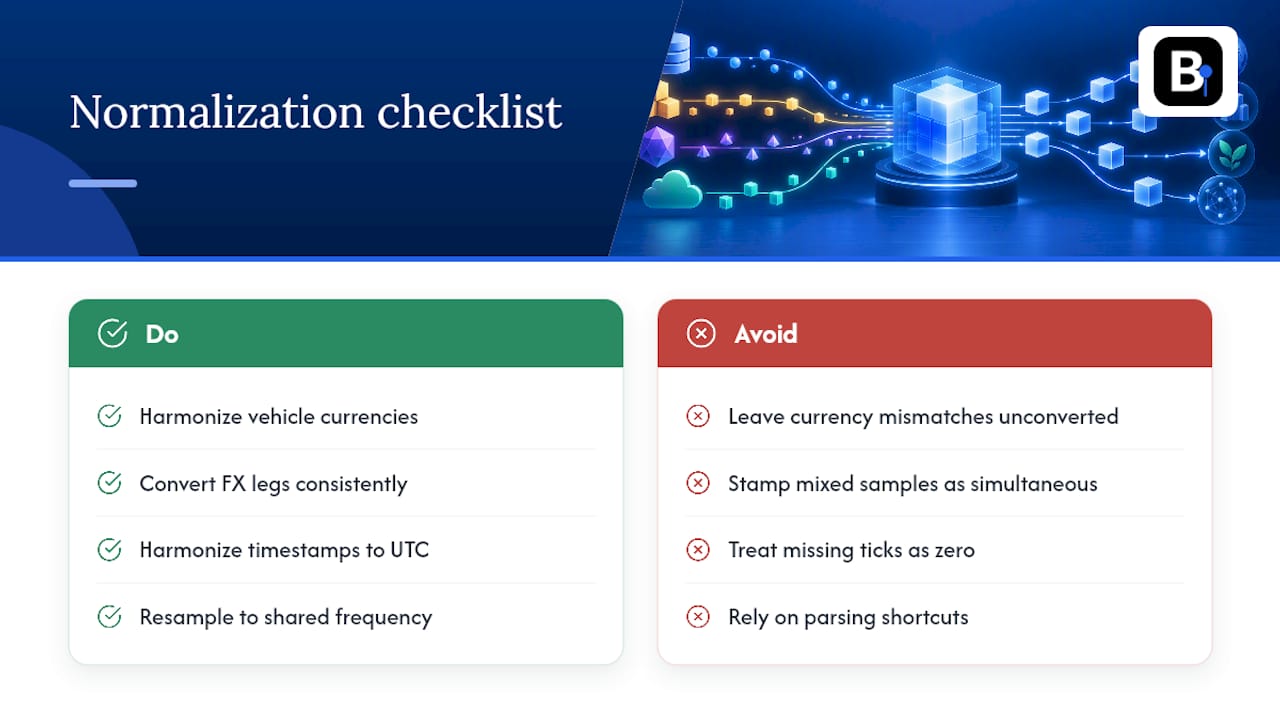
I modelli di analisi di portafoglio e di rischio sono affidabili solo quanto gli input che li alimentano, e le strategie cross-asset moltiplicano questa dipendenza, perché una singola posizione può toccare contemporaneamente azioni, FX e tassi. Una discrepanza valutaria che sfugge a una gestione non normalizzata del vehicle-currency non distorce solo un numero, ma si propaga in ogni calcolo a valle che ne dipende: value-at-risk, matrici di correlazione, esposizioni ai fattori.
I timestamp disallineati tra asset class sono una fonte particolarmente comune di errori silenziosi nei modelli di rischio. Un prezzo obbligazionario campionato a fine giornata e un tasso FX campionato intraday, entrambi marcati come se fossero avvenuti nello stesso istante, producono una stima di correlazione che non riflette nulla di reale. Una volta che i timestamp sono armonizzati su un unico standard UTC e ricampionati su una frequenza condivisa, le stime di correlazione e beta cross-asset diventano confrontabili in un modo che altrimenti non sarebbe possibile.
Anche la gestione normalizzata dei valori nulli conta qui. Un motore di rischio che tratta silenziosamente un tick mancante come rendimento pari a zero sottostimerà la volatilità di uno strumento poco scambiato, il che a sua volta sottostima il rischio a livello di portafoglio proprio dove conta di più, nella coda della distribuzione. Una semantica dei null coerente e ben documentata permette a un modello di rischio di compiere una scelta esplicita, riportare in avanti l'ultimo prezzo, escludere il periodo, segnalarlo, invece di una scelta accidentale incorporata da una scorciatoia di parsing.
Il vantaggio pratico della normalizzazione a questo livello riguarda meno l'eleganza e più la fiducia: un report di rischio su cui un portfolio manager può agire senza dover prima chiedersi se la componente FX sia stata convertita correttamente.
Strumenti e piattaforme per costruire pipeline di normalizzazione
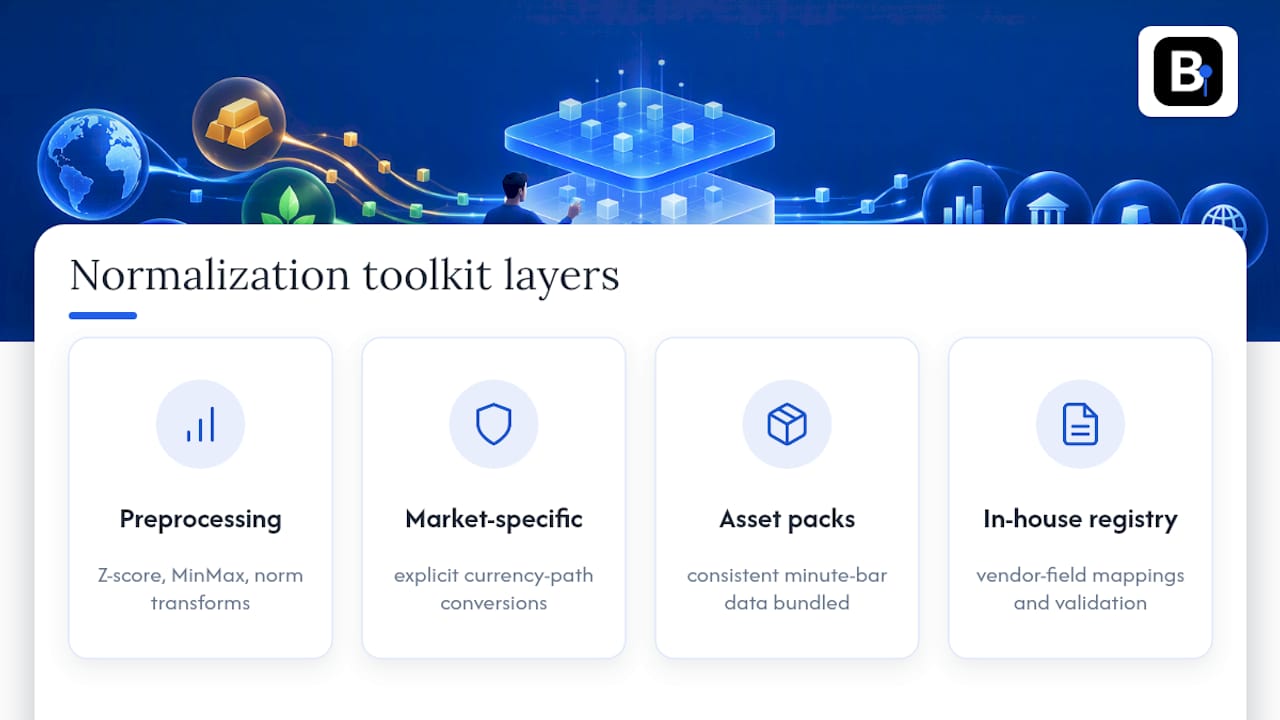
La maggior parte dei team assembla il proprio stack di normalizzazione mescolando librerie general-purpose e strumenti costruiti appositamente per i dati di mercato, piuttosto che affidarsi a un unico prodotto. Sul lato scaling e trasformazione, il modulo di preprocessing di scikit-learn rimane il toolkit predefinito per le trasformazioni Z-score, Min-Max e basate su norme, e si integra in modo pulito con le pipeline basate su pandas che la maggior parte dei team quant già utilizza.
Per il livello specifico dei dati di mercato, esistono librerie di normalizzazione costruite appositamente per gestire la conversione vehicle-currency e la mappatura degli schema multi-venue, un'area che le librerie ML generiche non affrontano. Il pacchetto market-data-normalizer è un esempio, costruito per imporre dichiarazioni esplicite dei percorsi valutari invece di lasciare che una conversione avvenga implicitamente all'interno di una funzione di trasformazione.
Sul lato acquisizione dati, un pacchetto completo per asset class come l'INDICES SuperPack di BacktestMarket elimina gran parte del lavoro di mappatura fornendo dati in minute bar già coerenti su un insieme di strumenti in un unico download, invece di richiedere un adapter separato per ogni fornitore di indici.
Al di là di questo, la maggior parte dei team continua comunque a scrivere internamente un proprio sottile livello di mappatura e validazione, poiché nessuno strumento pronto all'uso anticipa completamente le peculiarità di denominazione dei campi di ogni vendor. Il toolkit realistico è una combinazione: una libreria di preprocessing generica per la matematica, un pacchetto orientato alla normalizzazione per la gestione di valute e schema, e un registro interno mantenuto per le regole di mappatura specifiche del vendor che non si generalizzano mai del tutto.
Cosa mostrano i deployment reali sulla normalizzazione
Il segnale più chiaro dal mondo reale arriva dai sistemi di trade surveillance ed esecuzione, dove l'esempio di UNITY di Quod Financial mostra un miglioramento dell'efficienza operativa una volta che la normalizzazione avviene al momento della cattura del dato, invece di essere reimplementata da ciascun consumatore a valle. I team di surveillance, reporting ed esecuzione che in precedenza mantenevano una logica di traduzione separata per lo stesso feed grezzo convergono invece su un unico livello condiviso e sottoposto ad audit.
La modalità di fallimento si manifesta con la stessa coerenza sul lato opposto, nei team che saltano l'investimento upstream e normalizzano downstream, team per team, progetto per progetto. Il risultato prevedibile è codice adapter duplicato, gestione incoerente della stessa peculiarità del vendor tra un team e l'altro, e schema drift che passa inosservato perché nessun singolo team possiede l'intera superficie di mappatura. Un vendor che rinomina un campo rompe silenziosamente la pipeline di un team, mentre la logica di mappatura leggermente diversa di un altro team sopravvive per caso, e nessuno si rende conto che i due team stanno ormai lavorando con versioni sottilmente diverse degli stessi dati sottostanti.
La lezione pratica di entrambi i pattern è la stessa: il lavoro di normalizzazione svolto una sola volta, upstream, e trattato come infrastruttura condivisa tende a reggere. Il lavoro di normalizzazione svolto ripetutamente, downstream, da qualunque team ne abbia bisogno in un dato trimestre, tende a divergere.
Governance e compliance nella normalizzazione cross-asset
Le decisioni di normalizzazione non sono puramente tecniche: sono anche decisioni di audit. Un'azienda che non riesce a ricostruire esattamente come un messaggio FIX grezzo o un CSV di un vendor sia diventato un record canonico ha una lacuna che emerge nel momento peggiore possibile, durante un'indagine regolamentare o una disputa su un'operazione.
La documentazione conta quanto il codice stesso. Ogni regola di mappatura, ogni scelta di scaler, ogni adjustment applicato a una serie di prezzi dovrebbe essere tracciabile fino a un record sotto controllo di versione, non a un commento sepolto in uno script. Questa tracciabilità è ciò che permette a un team di compliance di rispondere a una domanda specifica, perché questa barra storica differisce dal feed grezzo del vendor, con una risposta concreta invece che con un'ipotesi.
Retention e riproducibilità derivano dalla stessa disciplina. Se uno schema canonico cambia, il cambiamento stesso ha bisogno di un record: cosa è cambiato, quando e perché, in modo che un backtest eseguito l'anno scorso possa ancora essere spiegato oggi, anche se la pipeline nel frattempo si è evoluta. La governance, in questo contesto, riguarda meno un livello di compliance separato aggiunto sopra, e più il trattare il registro di mappatura, la configurazione degli scaler e la versione dello schema come artefatti di prima classe, verificabili, al pari del codice che li utilizza.
Errori comuni degli sviluppatori con la normalizzazione
I team sottovalutano sistematicamente la manutenzione degli adapter. Una mappatura che funziona il primo giorno si rompe silenziosamente sei mesi dopo, quando un vendor aggiunge un campo, e nessuno se ne accorge finché un numero a valle non appare sbagliato. La soluzione è un registro di mappatura versionato, un diffing automatico dello schema contro ogni nuovo payload del vendor, e un rollout graduale per qualsiasi nuova fonte prima che tocchi la produzione. Pagare per dati upstream puliti e già normalizzati spesso costa meno delle ore di ingegneria spese per mantenere un adapter interno fragile.
— Inizio
Dove si inserisce BacktestMarket nel tuo progetto di normalizzazione
Costruire da zero un registro di mappatura per azioni, obbligazioni, FX e commodity richiede un tempo di ingegneria reale, e ogni peculiarità del vendor che devi decodificare per reverse engineering è tempo non speso sui tuoi modelli. I dataset in minute bar di BacktestMarket arrivano già puliti e con timestamp coerenti, quindi il lavoro di armonizzazione di schema e timestamp descritto sopra è in gran parte già svolto prima che il file raggiunga la tua pipeline.
Per i team che coprono specificamente strumenti su indici, l'INDICES SuperPack raggruppa un'intera asset class in un unico download pronto all'importazione, invece di richiedere un'integrazione separata per ogni strumento. Il piano annuale a 119 EUR all'anno garantisce accesso continuativo a tutto il catalogo, e la più ampia libreria di dati storici copre ulteriori asset class se la tua pipeline ha bisogno di espandersi. Controlla i dataset attualmente disponibili e avvia il tuo prossimo backtest con un feed che ti fa risparmiare il lavoro di adapter.
Fonti
- Normalization in Machine Learning: When to Use
- Preprocessing data — scikit-learn documentation
- Why Upstream Data Normalization Is Changing Trade Surveillance - Quod Financial
- What is normalized market data? A developer's guide to clean financial schemas
- market-data-normalizer 1.35.0 (project notes)
FAQ
Cosa significa in pratica la normalizzazione dei dati cross asset?
Significa che ogni strumento, indipendentemente dall'asset class o dalla venue di origine, arriva nel tuo sistema con gli stessi nomi di campo, gli stessi tipi, lo stesso formato di timestamp e la stessa gestione dei null. Questa coerenza è ciò che permette a un'unica pipeline di elaborare azioni, FX e obbligazioni senza logiche separate per ciascuna.
Quale scaler dovrei usare per le serie temporali finanziarie?
La standardizzazione Z-score è la scelta predefinita comune per i rendimenti e altre feature approssimativamente simmetriche, mentre RobustScaler è la scelta migliore quando una serie presenta outlier significativi, come picchi di volume. Il Min-Max scaling si adatta agli input con limiti fissi noti.
La normalizzazione dovrebbe avvenire upstream o downstream?
Normalizzare upstream, al momento della cattura del dato, riduce la duplicazione del lavoro sugli adapter e offre a ogni sistema a valle una base condivisa e coerente, come dimostra l'esempio UNITY di Quod Financial nella trade surveillance. La normalizzazione downstream resta comunque adatta al prototyping di ricerca rapido, dove la flessibilità conta più dell'infrastruttura condivisa.
Quale formato di timestamp dovrebbero usare i dati di mercato normalizzati?
ISO-8601 UTC è il formato standard citato in tutte le guide per sviluppatori sui dati di mercato normalizzati, poiché elimina l'ambiguità che causa bug legati all'ora legale e ai fusi orari. Ogni timestamp dovrebbe essere convertito in questo formato prima di entrare nel tuo archivio canonico.
BacktestMarket fornisce dati pre-normalizzati?
BacktestMarket fornisce dati storici puliti in minute bar, con timestamp coerenti e adjustment documentati, pronti per l'importazione diretta in MT4 e MT5. Questo riduce, senza però eliminarlo del tutto, il lavoro di mappatura e validazione necessario per portare i dati in uno schema cross-asset pienamente canonico.
Consigliati
- Data Snooping Bias: How Researchers and Quants Catch It
- What Good Data Vendor Support Actually Looks Like
- Audit First MT5 Backtesting Data: Gap, Timestamp, Ready to Import
- Holiday Gaps in Market Data: A Quant's Handling Guide
Risorse correlate
Esplora i dati storici forex di BacktestMarket per mettere in pratica le idee illustrate in questo articolo.