Per i dataset minute-bar, la velocità di consegna dati è il tempo che intercorre tra la richiesta di un dataset e il momento in cui questo è verificato e pronto sul disco locale. Il percorso più veloce è un download bulk una tantum in uno storage locale e columnar, non chiamate API ripetute durante i backtest. BacktestMarket e provider come LSEG indicano entrambi la stessa soluzione: raggruppa la richiesta, scarica una volta sola, e leggi in locale per sempre dopo.
TL;DR:
- Raggruppa le richieste per più simboli e intervalli di date invece di richiedere i dati in sequenza, per ridurre drasticamente i tempi di download.
- Programma i grandi pull di dati durante le ore di minor traffico ed evita i periodi di picco alla chiusura dei mercati per prevenire ritardi dovuti al throttling del provider.
- Archivia i dati localmente in formati come Parquet o DuckDB per consentire un accesso più veloce e minimizzare i download ripetitivi via rete.
- Automatizza le procedure di validazione dei dati per individuare gap, duplicati e incongruenze nei timestamp prima di avviare i backtest, risparmiando tempo di troubleshooting in seguito.
- Usa i download diretti da cloud storage quando supportati, e costruisci trasferimenti segmentati e ripristinabili per migliorare affidabilità e velocità su connessioni instabili.
Indice
- Cosa rallenta realmente la consegna dei dati minute-bar?
- Come velocizzare realmente la consegna dei dati?
- Conviene archiviare l'intero dataset in locale?
- È necessario validare i dati prima del backtesting?
- Perché i dataset pre-validati e pronti all'importazione cambiano l'equazione della consegna
- La tua checklist pre-esecuzione prima di ordinare i dati
- Ottieni la velocità di consegna dati giusta fin dal primo download
- Fonti
- FAQ
Cosa rallenta realmente la consegna dei dati minute-bar?
Tre forze determinano quanto velocemente un dataset arriva sulla tua macchina, e la maggior parte dei trader ne combatte solo una.
La banda è il limite più ovvio, ma raramente è il vero collo di bottiglia per i file minute-bar. Un anno di barre a un minuto per una singola coppia forex può occupare poche centinaia di megabyte; una connessione simmetrica a 100 Mbps la scarica in pochi secondi. Il collo di bottiglia di solito si trova a monte, dal lato del provider.
I picchi di carico lato server colpiscono più duramente proprio alla chiusura del mercato, quando tutti richiedono i dati dello stesso giorno contemporaneamente. I provider limitano le estrazioni concorrenti per template di report per mantenere stabili i tempi di risposta per tutti, il che significa che il tuo job va in coda dietro a quelli di altri utenti proprio nella finestra in cui vorresti i dati più velocemente.
I rate limit delle API aggravano il problema. Estrarre dati un simbolo alla volta, una richiesta al secondo, trasforma un download di 100 simboli in un job che dura ben oltre 100 secondi, mentre con accesso bulk o illimitato si riduce a meno di un secondo. Le chiamate API sincrone spesso vanno in timeout intorno ai trenta secondi, quindi qualsiasi richiesta che impiega più tempo può fallire e richiedere un nuovo tentativo.
Il pattern peggiore in assoluto: recuperare le barre storiche live, a metà del backtest, invece che in anticipo. È lento, è non-deterministico, e trasforma una domanda di ricerca in un problema di networking. I punti critici più comuni includono:
- Chiamate API sequenziali per singolo simbolo invece di endpoint batch/bulk
- Richieste inviate durante i picchi di carico del provider (chiusura del mercato, fine mese)
- Chiamate sincrone che superano le finestre di timeout su ampi intervalli di date
- Assenza di cache locale, per cui ogni backtest riattiva lo stesso download
Come velocizzare realmente la consegna dei dati?
Sistemare la velocità di consegna riguarda soprattutto quando e come richiedi i dati, non aggiornare la connessione internet.
- Raggruppa, non ciclare. Richiedi simboli e intervalli di date in blocco invece di ciclare una chiamata per ogni simbolo. Questa da sola è la leva singola più potente disponibile, riducendo un job di oltre cento secondi a meno di uno nei benchmark dei provider.
- Programma nelle ore di minor traffico. Esegui i grandi pull al di fuori delle finestre di chiusura del mercato e scagliona i job concorrenti in modo da non competere con le tue stesse richieste per lo stesso slot in coda.
- Passa all'asincrono per i job lunghi. Usa endpoint di estrazione asincroni che restituiscono un URL da interrogare in seguito, invece di una chiamata sincrona che muore intorno ai 30 secondi.
- Scarica direttamente dal cloud storage. Dove un provider supporta download diretti da S3, usali. Questo aggira completamente il server API e instrada il trasferimento attraverso un'infrastruttura costruita per il throughput, non per la logica delle query.
- Prevedi la ripristinabilità. Download segmentati e ripristinabili, con concorrenza controllata e backoff esponenziale sui retry, evitano che una connessione interrotta costringa a un riavvio completo.
Pro Tip: Traccia tre numeri ogni volta che scarichi dati: time-to-first-byte, throughput sostenuto in megabyte al secondo, e tempo totale reale (wall-clock) fino a un file locale verificato. Se il time-to-first-byte è alto ma il throughput è buono una volta avviato, il problema è la coda, non la banda, e nessun aggiornamento della connessione lo risolverà.
Conviene archiviare l'intero dataset in locale?
Sì, ed è la decisione architetturale singola più importante che influisce sulla velocità di consegna. Scarica una volta, archivia in locale, leggi molte volte. Questo pattern trasforma un problema di rete in un problema di lettura da disco, e le letture da disco si misurano in millisecondi, non in minuti.
La scelta del formato conta più di quanto la maggior parte dei trader pensi. Il CSV è portabile ma lento da analizzare su larga scala. I formati columnar cambiano completamente i termini del problema:
- Parquet comprime bene e permette di leggere solo le colonne e gli intervalli di date di cui hai bisogno, il che conta quando un file minute-bar pluriennale su decine di strumenti altrimenti soffocherebbe un loader ingenuo.
- Feather sacrifica un po' di compressione per una velocità di lettura quasi istantanea, utile per la ricerca iterativa in cui ricarichi lo stesso file decine di volte al giorno.
- DuckDB permette di eseguire query in stile SQL direttamente sui file Parquet, spesso di un ordine di grandezza più veloce rispetto alla scansione di CSV grezzi per backtest multi-simbolo.
La disciplina nell'organizzazione ripaga più avanti. Organizza per strumento e anno, mantieni un manifesto di ciò che è stato validato e quando, e versiona il tuo storage locale come faresti col codice. Invece di riscaricare tutto ogni mese, aggiungi solo il delta nuovo e compatta periodicamente i file per evitare migliaia di piccoli frammenti.
Per l'importazione in MT4 e MT5, mantieni il tuo storage locale esattamente nel formato di barre che la piattaforma si aspetta prima di convertire. Un file pre-formattato e pronto all'importazione evita un secondo passaggio di conversione ogni volta che aggiorni i dati. Se sei nuovo a questo passaggio di conversione, la nostra guida all'importazione di dati storici in MetaTrader illustra la mappatura passo per passo.
È necessario validare i dati prima del backtesting?
Sempre, e richiede minuti, non ore, se lo automatizzi. Un download veloce pieno di gap o duplicati fa perdere più tempo di uno lento, perché te ne accorgi solo quando i risultati del backtest sembrano sbagliati.
- Elimina i duplicati su una chiave composita. Imponi una chiave univoca su simbolo più timestamp del minuto, sia a livello applicativo che come indice a livello di storage, così le barre duplicate provenienti da richieste ripetute non vengono mai conteggiate due volte senza accorgersene.
- Rileva i gap rispetto al calendario di borsa. Confronta il numero atteso di minuti con i record effettivamente archiviati per ogni sessione di trading, poi classifica i gap come festività, sospensioni o dati effettivamente mancanti.
- Allinea la convenzione dei timestamp. Verifica se ogni barra è timestampata all'inizio o alla fine del minuto, e normalizzala una volta per tutto il tuo storage, poiché convenzioni disallineate spostano silenziosamente ogni segnale del backtest.
- Ripara ciò che manca. Usa re-download mirati per i gap brevi, backup dei tick in tempo reale per ricostruire i buchi recenti, o la sintesi delle barre quando un provider non può reintegrare lo storico.
- Automatizza la scansione. Esegui un audit giornaliero che segnala le anomalie prima ancora di toccare i dati in un backtest, non dopo che una strategia produce rendimenti sospetti.
La nostra checklist di audit per i dati di backtesting MT5 copre questo workflow in maggior dettaglio se vuoi un processo ripetibile.
Perché i dataset pre-validati e pronti all'importazione cambiano l'equazione della consegna
Un dataset già pulito e formattato elimina la maggior parte del problema di velocità di consegna prima ancora che inizi. Alcuni provider offrono dati storici intraday minute-bar su varie classi di asset, consegnati come un unico download all-in-one pronto per l'importazione diretta in MT4 e MT5.
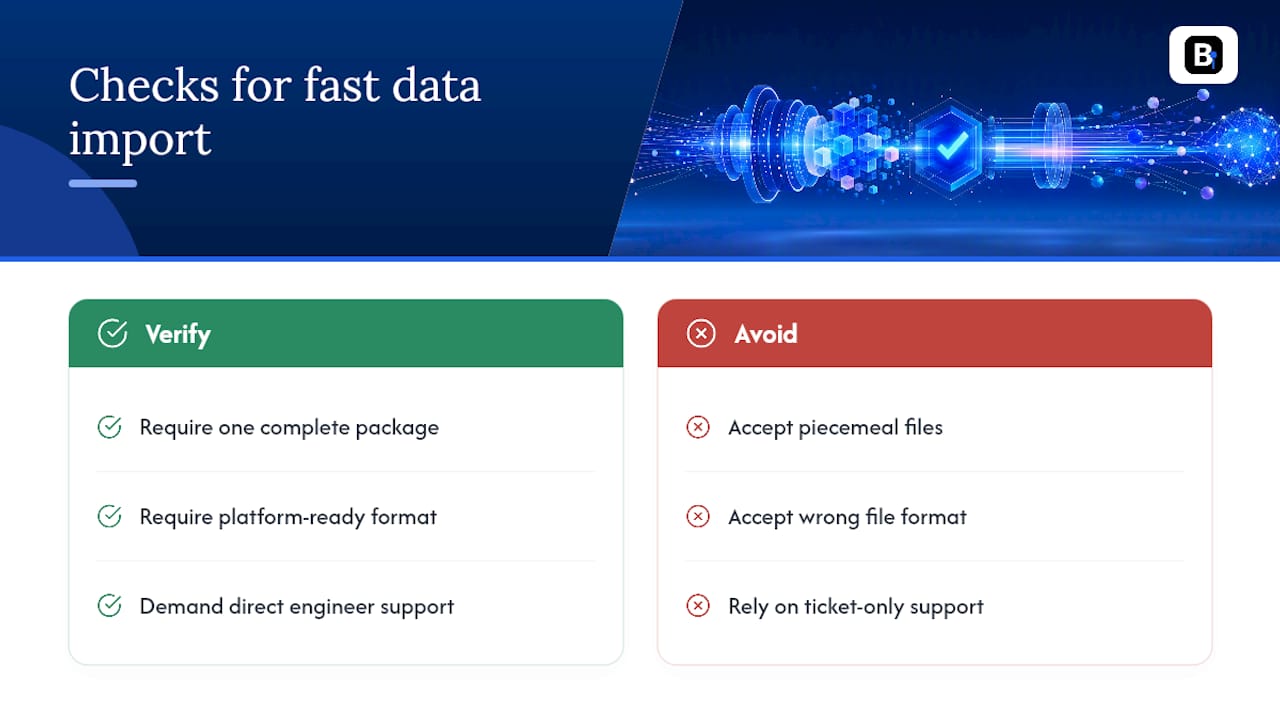
Quando valuti i dati di un qualsiasi vendor, verifica tre cose: arriva come un unico pacchetto completo invece che come file frammentati, è già nel formato che la tua piattaforma si aspetta, e puoi raggiungere un vero ingegnere, non una coda di ticket, se l'ingestione si rompe. Un buon supporto arriva direttamente dagli ingegneri che raccolgono e validano i dati, il che accorcia notevolmente il troubleshooting. Questa combinazione è ciò che distingue un dataset che puoi importare da uno che è stato semplicemente scaricato.
La tua checklist pre-esecuzione prima di ordinare i dati
Scarica e verifica il dataset completo prima di scrivere anche solo una riga di codice della strategia. Riscalda la cache locale con una lettura di benchmark rapida per confermare la velocità di accesso. Automatizza gli aggiornamenti incrementali nelle ore di minor traffico, e registra ogni tempo di trasferimento e fallimento dei retry. Venti minuti di configurazione qui ti risparmiano giorni di debug di un backtest che non era mai il vero problema.
— Inizia
Ottieni la velocità di consegna dati giusta fin dal primo download
BacktestMarket esiste perché estrarre dati live durante un backtest è il pattern sbagliato, e la maggior parte dei problemi di velocità di consegna che i trader affrontano sono in realtà problemi di sourcing dei dati mascherati. Invece di assemblare chiamate API contro rate limit e finestre di timeout, ottieni un unico download pulito e pronto all'importazione su forex, metalli, obbligazioni e indici azionari, formattato per MT4 e MT5 fin dall'inizio.
Se hai bisogno di accesso ricorrente su più classi di asset, il Piano Annuale copre gli aggiornamenti continui del dataset e il supporto diretto degli ingegneri per 119€ all'anno. Se ti serve solo un dataset ora, vai direttamente su Historical Data e scarica un file di esempio per confermare che il formato corrisponda alla tua piattaforma prima di impegnarti in un backtest completo. Se l'ingestione genera un errore, a risponderti sono gli ingegneri che hanno costruito la pipeline, non uno script di supporto.
Fonti
La guida di LSEG al download dello storico dei tick copre in profondità pattern di batching e asincroni. La fair usage policy di DataScope Select descrive nel dettaglio la configurazione del download diretto da S3.
- How optimize tick history file downloads (LSEG Developers)
- How to detect and fix problems in intraday market data — Concretum Group
FAQ
Qual è un buon benchmark di time-to-availability per i dati minute-bar?
Non esiste un numero universale poiché dipende dalla dimensione del file e dal provider, ma l'obiettivo è un unico file locale verificato, non un feed live da re-interrogare. Traccia il tuo time-to-first-byte e il tempo totale di trasferimento a ogni download, così hai una baseline per individuare peggioramenti.
Il batching delle richieste fa davvero così tanta differenza?
Sì. I benchmark dei provider mostrano che l'accesso batch o bulk può ridurre il tempo di download da oltre 100 secondi a meno di 1 secondo, per lo stesso job di 100 simboli che altrimenti girerebbe a una richiesta al secondo.
Perché la mia chiamata API va sempre in timeout su ampi intervalli di date?
Le chiamate API sincrone tipicamente falliscono intorno ai 30 secondi, quindi una richiesta che copre un'ampia finestra storica spesso supera quel limite prima che il server risponda. Passare a un endpoint asincrono che restituisce un URL da interrogare in seguito evita completamente il timeout.
In che formato dovrei archiviare localmente i dati minute-bar?
I formati columnar come Parquet, o un motore embedded come DuckDB che legge file Parquet, sono in genere molto più veloci per letture multi-simbolo rispetto al CSV grezzo. Entrambi comprimono bene e permettono di interrogare solo le colonne e gli intervalli di date effettivamente necessari a un dato backtest.
Consigliati
- Minute Bar Data: What Quants Need for Reliable Backtests
- How to Achieve 99% Modeling Quality in MT4 for Backtests
- Holiday Gaps in Market Data: A Quant's Handling Guide
- 5 Audits Quants Must Run on Outlier Handled M1 Data Before MT4/MT5
Risorse correlate
Esplora i pacchetti di dati storici di BacktestMarket per mettere in pratica le idee di questo articolo.