Un backtest credibile sulla modellazione dello spread tratta il bid-ask spread come dinamico e dipendente dal regime, incorpora commissioni e slippage su ogni round trip, e valida i risultati con CPCV walk-forward anziché un singolo percorso storico. Se si trascura uno di questi aspetti, il vantaggio ottenuto nel backtest di una strategia è in parte un artefatto di frizioni non modellate. Quando i dati di quotazione mancano, gli stimatori accademici colmano il vuoto, e gli ordini di dimensioni maggiori richiedono uno scaling conservativo dell'impact per evitare di gonfiare artificialmente dimensioni di posizione che, nella pratica, muoverebbero il mercato.
TL;DR:
- Usa stime CHL giornaliere basate su prezzi high, low e close quando le quotazioni non sono disponibili; porta a zero le letture negative, specialmente per strumenti illiquidi.
- Esegui il fill all'apertura della barra successiva, addebita spread e commissione sia in entrata che in uscita, e allarga le ipotesi di spread durante news o stress di liquidità.
- Per ordini più grandi, applica la legge della radice quadrata alla dimensione dell'ordine rispetto al volume medio, consenti fill parziali, e testa lo Sharpe netto con ipotesi di impact raddoppiate.
- Valida con finestre walk forward, CPCV, label con embargo, e test di permutazione Monte Carlo; riporta Sharpe corretto per i costi, turnover e rendimenti stress al quinto percentile.
Indice
- Cosa deve rappresentare la modellazione dello spread per backtest credibili
- Stimare gli spread quando mancano i dati a livello di quotazione
- Modellazione dell'esecuzione: slippage, market impact e dipendenza dal regime
- Integrare i modelli di spread nei backtest ML e nelle pipeline di validazione
- Considerazioni pratiche sui dati e come un dataset minute-bar pulito cambia la modellazione dello spread
- Prospettiva dell'autore: checklist delle best practice per backtest ML spread-aware
- Come i dati di BacktestMarket si inseriscono in questo workflow
- FAQ
- Fonti
Cosa deve rappresentare la modellazione dello spread per backtest credibili
Le ipotesi di costo a percentuale fissa sottostimano il rischio perché ignorano il fatto che gli spread si allargano esattamente quando la liquidità scompare, momento in cui le strategie tendono anche a tradare di più. Un'ipotesi fissa di 2 basis point potrebbe reggere in un tranquillo martedì pomeriggio e fallire completamente durante il rilascio di un dato economico, un gap di liquidità, o un'apertura dopo il weekend.
Un modello di spread degno di fiducia deve rappresentare diversi aspetti contemporaneamente:
- Spread variabili che si allargano durante le ore a bassa liquidità, intorno alle news, e alle aperture o chiusure di sessione
- Campi di commissione espliciti separati dal costo dello spread, dato che i broker addebitano entrambi
- Contabilità round-trip che addebita il costo due volte, una in entrata e una in uscita
- Fill sulla barra successiva anziché sulla stessa barra, così che il prezzo simulato rifletta ciò che era effettivamente negoziabile
- Floor di tick-size che mantengono gli spread discreti anziché continui per strumenti a basso prezzo
Il default pragmatico su cui converge la maggior parte dei practitioner è l'esecuzione sulla barra successiva con costi round-trip addebitati esplicitamente e un moltiplicatore condizionale applicato durante finestre taggate come stress o news. Taggare i regimi può essere semplice come segnalare rilasci economici programmati e picchi di volatilità realizzata, per poi allargare lo spread modellato di un multiplo fisso durante quelle barre. Anche le variazioni minime di prezzo di borsa contano in questo contesto: per i titoli a basso prezzo, i tick size discreti influenzano materialmente gli spread e le dimensioni delle quotazioni, quindi un modello di spread continuo riporterà in modo errato i costi specificamente per quegli strumenti.
Stimare gli spread quando mancano i dati a livello di quotazione
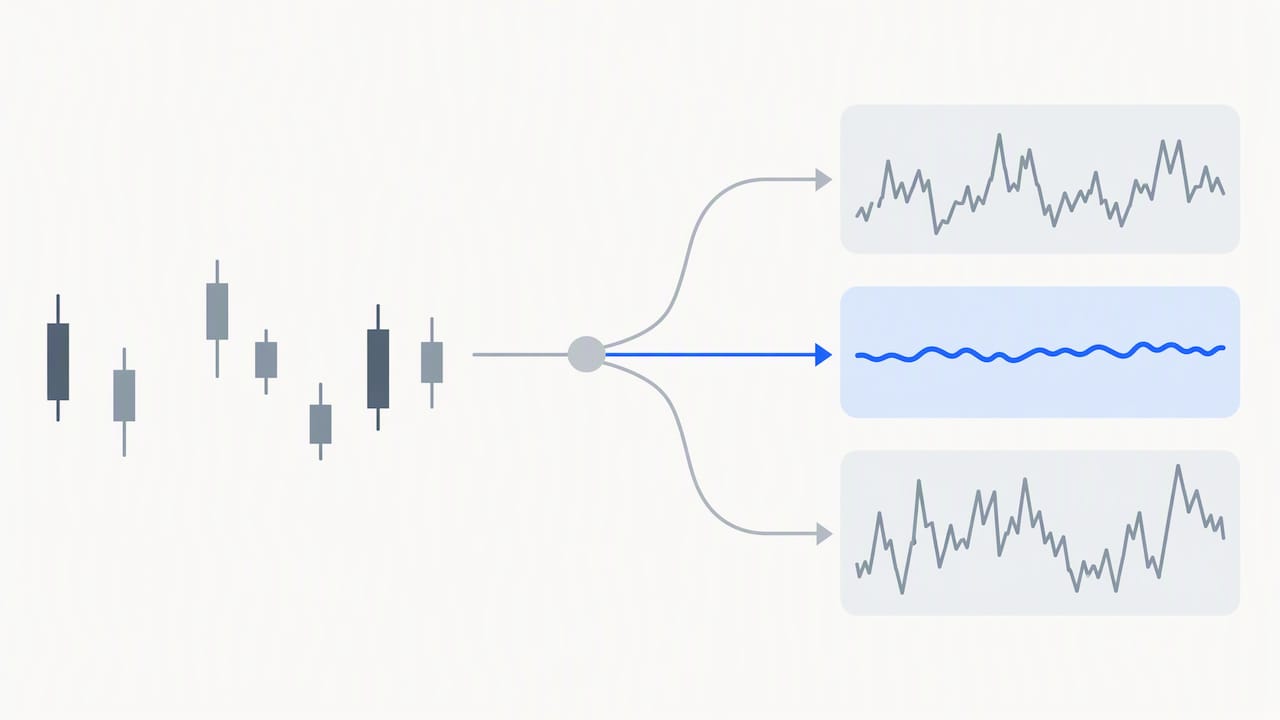
Quando i dati a livello di quotazione non sono disponibili, tre stimatori a bassa frequenza coprono la maggior parte dei casi pratici, ciascuno con requisiti di dati e modalità di fallimento diversi.
- Lo stimatore di Roll utilizza solo variazioni di prezzo consecutive e la loro covarianza seriale, non richiede dati di high o low, ma si rompe quando i rendimenti sono positivamente autocorrelati e produce spesso stime indefinite o negative su strumenti in trend.
- Corwin-Schultz utilizza range high-low su due giorni per separare la volatilità dallo spread, migliorando rispetto a Roll ma rimanendo comunque sensibile a gap e jump overnight.
- CHL (in stile Abdi-Ranaldo), che utilizza congiuntamente prezzi high, low e close, produce stime con una correlazione maggiore rispetto agli spread effettivi TAQ reali rispetto a entrambi i predecessori, e performa particolarmente bene su strumenti meno liquidi, secondo una ricerca pubblicata su The Review of Financial Studies.
La ricetta pratica: calcola le stime CHL giornaliere, aggregale in una media mensile corretta su due giorni per attenuare il rumore, porta a zero qualsiasi valore negativo anziché trattarlo come segnale di rebate, poi scala per il volume giornaliero per mappare la stima mensile in basis point per singolo trade. Uno schema semplificato è il seguente: estrai high, low e close giornalieri; calcola lo spread CHL secondo la formula pubblicata; fai una media su una finestra mobile; converti il valore mensile in bps in un costo per trade dividendo per il numero atteso di trade al mese per quello strumento.
Un risultato documentato su cui vale la pena ancorare la scelta dello stimatore: lo stimatore CHL supera le alternative più datate specificamente sugli strumenti meno liquidi, aspetto che conta di più proprio per gli strumenti dove i dati di quotazione tendono a essere più scarsi.
Modellazione dell'esecuzione: slippage, market impact e dipendenza dal regime
Slippage e market impact non sono lo stesso costo. Lo slippage è più vicino a un pavimento, la frizione minima derivante dall'attraversare lo spread su un ordine piccolo, mentre il market impact cresce con la dimensione dell'ordine rispetto alla liquidità disponibile e non scala in modo lineare. Un modello pratico a cui molti practitioner fanno ricorso è la legge della radice quadrata: l'impact scala con la radice quadrata della dimensione dell'ordine divisa per il volume medio, moltiplicata per una costante dipendente dalla volatilità. Gli ordini piccoli potrebbero vedere un impact prossimo al mezzo spread quotato, mentre un ordine dimensionato a più volte il volume medio della barra può vedere multipli di impact molto maggiori, motivo per cui le ipotesi di mezzo spread fisso sottostimano il costo per qualsiasi dimensione oltre quella piccola.
Costruisci lo strato di esecuzione intorno ad alcune regole:
- Esegui il fill degli ordini all'apertura della barra successiva, mai al close della barra del segnale
- Consenti fill parziali quando la dimensione dell'ordine supera il volume tipico di una barra
- Abbina ogni entrata alla sua uscita in modo esplicito, così che il P&L rifletta l'intero round trip, non un mark-to-market corrente che ignora il costo non ancora scaricato
Durante finestre taggate come news o stress, allarga sia l'ipotesi di spread che la costante di impact in modo conservativo, anziché riutilizzare i parametri di un mercato calmo.
Pro Tip: Esegui il tuo backtest due volte con le costanti di impact impostate sulla tua stima base e sul doppio di quella stima; se lo Sharpe netto della strategia collassa tra le due, il tuo vantaggio è troppo sottile per sopravvivere all'esecuzione reale.
Integrare i modelli di spread nei backtest ML e nelle pipeline di validazione
Trasformare la modellazione dello spread in qualcosa che una pipeline di validazione possa utilizzare inizia con il feature engineering e termina con un reporting consapevole dei costi.
- Costruisci le feature di spread a partire da un hedge ratio filtrato con Kalman tra strumenti correlati, poi calcola z-score, half-life OU e spread aggiustato per la volatilità sul residuo filtrato, congelando l'hedge ratio a ogni confine di ribilanciamento per evitare overtrading causato da un beta in continuo cambiamento.
- Etichetta i risultati con label triple-barrier o forward-window, e imponi un periodo di embargo tra le finestre di training e test in modo che le informazioni delle barre adiacenti non trapelino mai attraverso la suddivisione.
- Valida con walk-forward optimization ancorata, ritarando gli iperparametri all'interno di ogni finestra anziché una sola volta globalmente, poi sovrapponi combinatorial purged cross-validation e test di permutazione Monte Carlo. Una pipeline di validazione di livello produttivo che combina walk-forward, CPCV e permutation testing è ciò che separa una vera abilità da una curva overfittata.
- Riporta le metriche al netto dei costi: Sharpe netto dopo spread, commissione e slippage; un punteggio di utilità implementabile che incorpora i costi direttamente nell'obiettivo anziché aggiungerli a posteriori; il rendimento al quinto percentile da ricampionamento Monte Carlo; e il turnover in basis point per ribilanciamento.
Sul fronte dell'utilità, il lavoro accademico sulla frontiera efficiente implementabile mostra che incorporare i costi di transazione direttamente nell'obiettivo di ottimizzazione, anziché applicarli come un haircut a posteriori, modifica il dimensionamento ottimale delle posizioni e produce una migliore utilità netta out-of-sample. Evita fill sulla stessa barra ovunque in questa pipeline. Un segnale calcolato sul close di una barra non dovrebbe mai eseguire il fill al prezzo di quella stessa barra, né in training né in validazione.
Considerazioni pratiche sui dati e come un dataset minute-bar pulito cambia la modellazione dello spread
Ogni stimatore sopra descritto vale quanto la serie di prezzi che lo alimenta. Timestamp rumorosi, barre mancanti e roll dei future non aggiustati gonfiano tutti gli spread stimati e distorcono i calcoli del turnover.
I dati minute-bar puliti eliminano diverse di queste criticità contemporaneamente:
- Intervalli di tick coerenti significano meno gap che costringono all'interpolazione
- Un timestamping corretto evita errori off-by-one che disallineano le feature di spread rispetto ai fill
- I back-adjustment pre-applicati sui future impediscono che salti artificiali alle date di roll si camuffino da allargamento dello spread
- La granularità per singola barra rende il tracking di turnover e costo round-trip computazionalmente diretto anziché approssimato a partire da barre giornaliere
Con granularità a livello di minuto, il tracking dello spread per barra e la contabilità dei costi basata sul turnover diventano qualcosa che si calcola direttamente anziché inferire statisticamente, che è esattamente l'input di cui gli stimatori in stile CHL e le pipeline walk-forward hanno bisogno per produrre risultati stabili.
Prospettiva dell'autore: checklist delle best practice per backtest ML spread-aware
Prima di dichiarare qualsiasi strategia pronta per il deployment, eseguila contro una breve checklist:
- Uno stimatore di spread a bassa frequenza applicato dove i dati di quotazione sono scarsi, con i valori negativi portati a zero
- Un modello di impact esplicito e consapevole della dimensione, non un'ipotesi di mezzo spread fisso
- Validazione walk-forward con CPCV e label con embargo, non un singolo split train-test
- Test di permutazione Monte Carlo con un Deflated Sharpe Ratio riportato
- Sopravvivenza a una replica di scenario di stress con parametri di spread e impact allargati
Per la revisione interna, il set minimo pubblicabile è lo Sharpe netto dopo tutti i costi, il turnover in basis point, e il rendimento al quinto percentile sotto lo scenario di stress. Una strategia che non può produrre tutti e tre questi numeri non è pronta per essere presentata a un desk.
— Start
Come i dati di BacktestMarket si inseriscono in questo workflow
Abbiamo costruito i nostri dataset esattamente per questo tipo di lavoro. Uno storico minute-bar pulito, pronto per l'importazione in MT4 e MT5 senza riformattazione, riduce il tempo di preparazione dei dati che di solito erode le ore che un quant ha realmente a disposizione per la stima dello spread e la progettazione della validazione.
- Il nostro Forex Major Full Pack offre minute bar pronte all'importazione su tutte le principali coppie per simulazioni spread-aware senza una pulizia dati separata.
- Il nostro catalogo più ampio di Historical Data copre metalli, bond e indici per testare il comportamento degli stimatori su diverse classi di attivo.
- Il supporto è disponibile per aiutarti a validare uno stimatore su un campione di download prima di impegnarti su un dataset completo.
Per i team che sviluppano strategie in modo ricorrente, il nostro Annual Plan a 119 EUR all'anno copre l'accesso continuativo ai dataset, e i nostri Expert Advisors e Indicatori ti offrono strumenti automatizzati da abbinare ai dati una volta che la tua pipeline di validazione ha superato i controlli. Per la meccanica di esecuzione una volta che passi al trading live, una guida pratica all'esecuzione degli ordini completa la modellazione dell'impact trattata sopra. Inizia con un campione di download e verificalo rispetto alle tue stime CHL prima di impegnarti su un pack completo.
FAQ
Cos'è uno spread modeling backtest?
Uno spread modeling backtest è una simulazione che addebita spread bid-ask variabile, commissioni e slippage su ogni trade anziché assumere un costo fisso o nullo. In genere allarga lo spread modellato durante finestre a bassa liquidità o di news, e addebita il costo sia in entrata che in uscita di ogni round trip.
Come posso fare il backtest degli spread se non ho dati di quotazione?
Usa uno stimatore a bassa frequenza come Corwin-Schultz o lo stimatore CHL/Abdi-Ranaldo, che derivano le stime di spread dai prezzi high, low e close giornalieri. CHL tende a superare gli stimatori più datati specificamente sugli strumenti meno liquidi, che è esattamente dove i dati di quotazione sono più difficili da reperire.
Cos'è il walk-forward CPCV e perché è importante per i backtest ML?
La validazione walk-forward riallena e ritesta un modello attraverso finestre mobili e ancorate anziché un unico split statico, e la combinatorial purged cross-validation (CPCV) aggiunge fold con embargo e purging per prevenire il data leakage tra i set di training e test. Una pipeline di validazione di livello produttivo abbina entrambe a test di permutazione Monte Carlo per separare una vera abilità dall'overfitting.
Quanto costano dati storici di spread accurati?
Il prezzo dipende dal dataset e dal fornitore; il nostro Historical Data e il Forex Major Full Pack sono quotati su richiesta, mentre l'accesso continuativo tramite il nostro Annual Plan è listato a 119 EUR all'anno. I costi variano altrove in base alla copertura degli asset, alla granularità dei tick e alla lunghezza dello storico.
Come dovrei modellare il market impact per ordini di dimensioni maggiori?
Un punto di partenza pratico è la legge della radice quadrata, dove l'impact scala con la radice quadrata della dimensione dell'ordine rispetto al volume medio anziché in modo lineare. I practitioner che modellano lo slippage solo come un mezzo spread fisso tendono a sottostimare significativamente i costi non appena la dimensione dell'ordine cresce oltre una piccola frazione del volume tipico di barra.
Fonti
Consigliati
- MT4 Portfolio Backtesting: Export Replay to Find Real Drawdowns
- Stop Fake Alpha: 5 Checks Quants Need for Hedging Backtesting Data
Risorse correlate
Esplora i pacchetti di dati storici di BacktestMarket per mettere in pratica le idee di questo articolo.