Usa Parquet quando analizzi ripetutamente tabelle di grandi dimensioni e ti interessano velocità, storage e coerenza dei tipi di dato. Usa CSV quando il file deve poter essere aperto ovunque, letto da una persona, oppure importato da software che accetta solo testo. La maggior parte dei workflow di dati seri finisce per usare entrambi: CSV ai margini, Parquet al centro.
Questa guida mette a confronto i due formati sugli aspetti che determinano la scelta: dimensione, velocità delle query, schema, compatibilità e comportamento in scrittura. Vedremo poi le impostazioni che rendono Parquet veloce o lento, con una sezione dedicata a cosa tutto questo significa per il lavoro su serie temporali come il backtesting di strategie di trading.
In breve
- Parquet è un formato binario, orientato alle colonne, con schema integrato e compressione. È più leggero e molto più veloce per query analitiche che coinvolgono solo alcune colonne.
- CSV è testo semplice, riga per riga. È universale, leggibile da una persona e facile da scrivere, ma più pesante, più lento da analizzare e poco rigoroso sui tipi di dato.
- In un benchmark pubblico su 11,2 milioni di righe, Parquet con ZSTD era 6,8 volte più piccolo del CSV e le query giravano 22-60 volte più velocemente.
- I punti deboli di Parquet: non puoi aprirlo in un editor di testo, e alcuni strumenti (tra cui MetaTrader 4 e 5, nel workflow di importazione descritto più avanti) continuano a richiedere CSV.
- La struttura del file conta: punta a circa 100K-1M di righe per row group e non aggiungere mai un secondo livello di compressione sopra Parquet.
Indice
- Come i due formati memorizzano i dati
- Parquet vs CSV a colpo d'occhio
- Dimensione del file: quanto è più piccolo Parquet?
- Velocità delle query: perché le colonne contano
- Schema e integrità dei dati
- Dove CSV vince ancora
- Configurare correttamente Parquet
- Cosa significa per il backtesting
- Il nostro punto di vista
- Dati minute-bar puliti, pronti per l'importazione
- Come scegliere: una checklist rapida
- FAQ
- Fonti
Come i due formati memorizzano i dati
CSV: testo, una riga alla volta
Un file CSV è composto da righe di testo con valori separati da un delimitatore, solitamente una virgola. Ogni riga viene memorizzata per intero, una dopo l'altra. Per leggere una singola colonna, un programma deve comunque scansionare e analizzare ogni riga.
Il CSV viene spesso descritto come uno standard, e l'RFC 4180 lo ha effettivamente definito come tipo MIME nel 2005. In pratica, i file che si trovano in giro variano per delimitatori, virgolette, fine riga, formati di data e separatori decimali. Nulla, all'interno del file, indica se 20240105 sia una data o un numero intero, o se un campo vuoto significhi zero o dato mancante.
Parquet: colonne, raggruppate e compresse
Apache Parquet è un formato di file open source, orientato alle colonne, progettato per un'archiviazione e un recupero efficienti, con schemi di compressione ed encoding integrati. (Per chi se lo chiede, si pronuncia "par-KAY", come la parola francese per il pavimento in legno.)
All'interno di un file, i dati sono suddivisi in row group. Ogni row group contiene column chunk, e ogni chunk è a sua volta diviso in pagine, come spiega la panoramica del formato di ClickHouse. Poiché tutti i valori di una colonna sono raggruppati insieme, si comprimono bene e possono essere letti senza toccare le altre colonne. Il file porta inoltre con sé il proprio schema e delle statistiche.
Parquet vs CSV a colpo d'occhio
| Criterio | CSV | Parquet |
|---|---|---|
| Struttura di archiviazione | Riga per riga, testo semplice | Colonna per colonna, binario |
| Dimensione del file | Maggiore | Molto più piccola, compressione integrata |
| Velocità delle query analitiche | Lenta: analizza ogni riga e campo | Veloce: legge solo le colonne necessarie, salta i chunk |
| Schema e tipi | Nessuno, dedotto dal lettore | Memorizzato nel file, imposto |
| Leggibile da una persona | Sì | No, serve uno strumento |
| Compatibilità | Quasi universale | La maggior parte degli strumenti analitici, meno programmi legacy |
| Scrittura | Semplice e veloce, adatta all'append | Più pesante, scritta a blocchi |
| Ideale per | Scambio, importazione, file piccoli, ispezione | Analisi ripetuta di tabelle di grandi dimensioni |
Dimensione del file: quanto è più piccolo Parquet?
Decisamente. Un benchmark di MotherDuck su 11.198.026 righe di corse taxi di New York ha misurato il CSV a 1,09 GB, contro 164 MB per Parquet con ZSTD (6,8 volte più piccolo) e 218 MB con Snappy (5,1 volte più piccolo).
Un confronto precedente di Ursa Labs va nella stessa direzione. I risultati dipendono dai dati: le colonne con molti valori ripetuti (simboli, categorie, flag) si comprimono in modo drastico, mentre le colonne di numeri in virgola mobile ad alta entropia si comprimono meno.
Puoi ridurre il CSV con gzip, e molti lo fanno. Questo restringe il divario su disco ma non il costo reale: un CSV compresso con gzip deve comunque essere decompresso interamente e analizzato come testo prima che qualsiasi query possa essere eseguita.
Velocità delle query: perché le colonne contano
Supponi di avere una tabella con 40 colonne e che la tua analisi ne usi solo tre. Con CSV, il motore legge e analizza tutte e 40 per ogni riga. Con Parquet, legge solo i tre column chunk di cui ha bisogno.
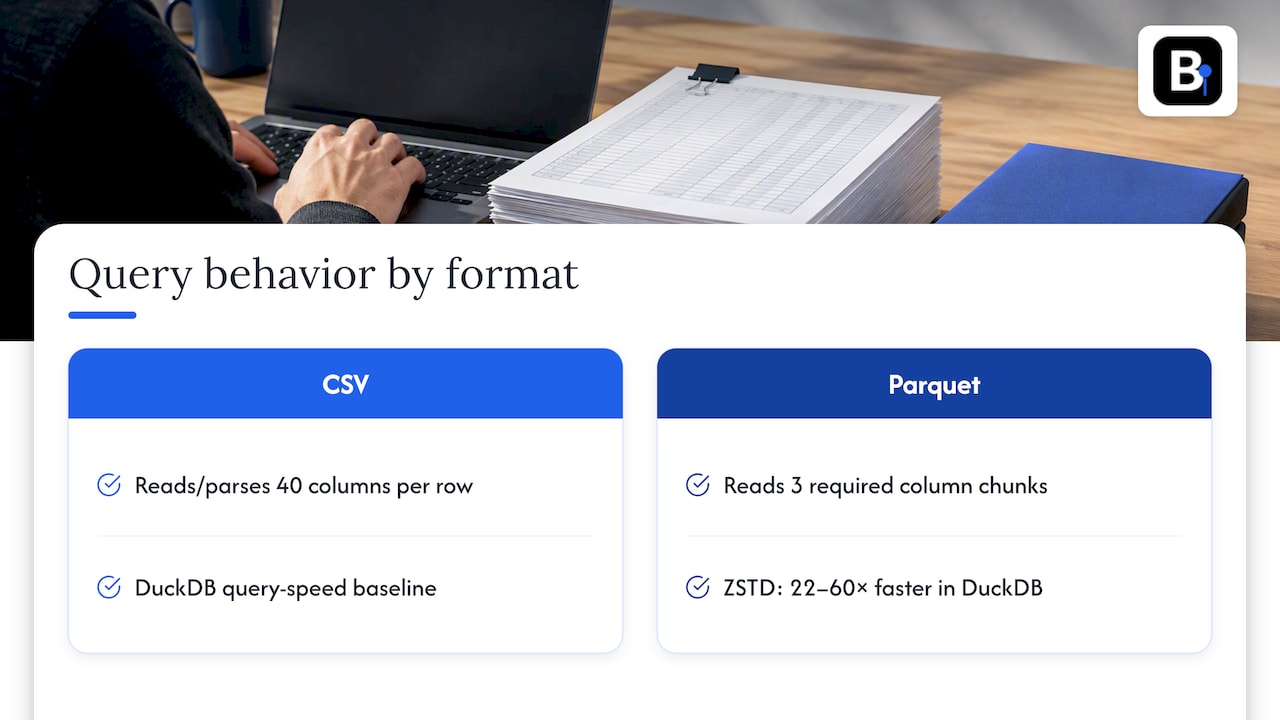
Nello stesso test di MotherDuck, Parquet con ZSTD ha girato da 22 a 60 volte più velocemente rispetto a CSV in DuckDB, a seconda di quante colonne toccava la query. Meno colonne servono, più grande è il divario.
Anche la velocità di decompressione fa parte della storia. L'analisi di ClickHouse ha rilevato che le migliori opzioni di compressione di Parquet sono quasi 10 volte più veloci da decomprimere rispetto a testo fortemente compresso come un CSV compresso con BZIP2. Se esegui la stessa analisi molte volte, questo costo viene pagato a ogni esecuzione.
Saltare i dati prima di leggerli
Parquet memorizza nei suoi metadati statistiche come valori minimo e massimo per ciascun column chunk. Un motore di query può usarle per saltare interi chunk che non possono soddisfare un filtro. Questo si chiama predicate pushdown, e DuckDB lo documenta come uno dei motivi per cui interrogare Parquet direttamente è efficiente. Un formato di testo non ha nulla di equivalente: per trovare righe in un intervallo di date, il motore deve leggere il testo.
La stessa idea alimenta i dataset storici su larga scala in altri ambiti della finanza. Se vuoi un altro esempio di letture selettive guidate dai metadati su grandi archivi, vedi questa guida ai grandi dataset storici per backtest riproducibili.
Schema e integrità dei dati
Questa è la differenza più sottovalutata. Parquet memorizza i tipi di colonna all'interno del file. Un timestamp è un timestamp, un float a 64 bit resta un float a 64 bit, e un lettore non può deciderlo silenziosamente in modo diverso. La ricerca sui formati analitici, come la rassegna del VLDB Journal sui formati di dati nei DBMS analitici, considera i formati su disco come Parquet progettati attorno a struttura ed encoding, caratteristiche che i file di testo non hanno.
Con il CSV, ogni consumatore deve indovinare. Modalità di fallimento comuni:
- Una colonna di prezzi viene letta come testo perché una riga contiene un carattere estraneo.
- Le date vengono interpretate come giorno-mese in uno strumento e mese-giorno in un altro.
- Gli zeri iniziali scompaiono dagli identificativi.
- Una virgola decimale in un'esportazione europea divide un numero in due campi.
- I timestamp perdono il fuso orario, e nulla indica quale fosse.
Nessuno di questi è un difetto nel tuo codice di analisi. Sono il costo di un formato che non porta con sé alcun tipo. Per qualsiasi caso in cui un solo valore errato cambia un risultato, un formato tipizzato elimina un'intera classe di errori silenziosi.
Dove CSV vince ancora
Parquet non è migliore in tutto. Scegli CSV quando:
- Il destinatario è una persona o un programma legacy. Puoi aprire un CSV in un foglio di calcolo o in un editor di testo e vedere esattamente cosa contiene. Parquet richiede una libreria o un visualizzatore.
- Il file è piccolo. Poche migliaia di righe si caricheranno istantaneamente in entrambi i casi, e gli strumenti aggiuntivi non ne valgono la pena.
- Stai facendo streaming o append. Scrivere un'altra riga in un CSV è banale. I file Parquet vengono scritti a blocchi e non sono pensati per ricevere append riga per riga.
- Devi importare in un software che accetta solo testo. Molte piattaforme di trading, strumenti contabili e database più datati accettano solo CSV.
- Devi fare diff o patch del file con i normali strumenti testuali.
Configurare correttamente Parquet
Un file Parquet scritto male può perdere gran parte del suo vantaggio. Tre impostazioni contano.
Dimensione del row group
Un file con un unico enorme row group non può essere letto in parallelo, e uno con row group minuscoli paga un pesante overhead. Le indicazioni di DuckDB suggeriscono di puntare a row group di circa 100K-1M di righe, così che ogni thread della CPU possa elaborare un gruppo in modo indipendente.
Il progetto Parquet stesso raccomanda row group di grandi dimensioni (da 512 MB a 1 GB) per l'I/O sequenziale, un valore calibrato per lo storage distribuito. Su una workstation, ragionare in termini di righe per gruppo, allineate al numero di thread disponibili, è l'approccio più pratico.
Dimensione del file
Per analisi in stile DuckDB, file singoli compresi tra 100 MB e 10 GB sono l'intervallo consigliato. Migliaia di file minuscoli rallentano tutto; lo stesso vale per un unico file di centinaia di gigabyte.
Compressione
Parquet comprime internamente con codec come Snappy, ZSTD o LZ4. Non comprimere con gzip il file finito in .parquet.gz: non si guadagna quasi nulla in dimensione e si aggiunge lavoro per la CPU a ogni lettura. Se esegui spesso le stesse query, codec più leggeri come Snappy o LZ4 evitano che la decompressione diventi il collo di bottiglia. ZSTD produce file più piccoli, come mostrato dal benchmark sopra, a un costo moderato in termini di velocità.
Cosa significa per il backtesting
I backtest sono un carico di lavoro quasi ideale per Parquet: tabelle grandi e ordinate temporalmente, molte esecuzioni ripetute, e query che di solito toccano poche colonne (timestamp, open, high, low, close) su un intervallo di date. Letture ripetute di un file tipizzato, compresso e con skip dei chunk sono più veloci che analizzare nuovamente il testo ogni volta. Se costruisci una tua pipeline di ricerca in Python, un livello Parquet per i dati puliti è una scelta progettuale sensata. La nostra panoramica sui formati di dati di mercato per sviluppatori e quant tratta Parquet insieme agli encoding binari e ai tipi di barre alternativi.
Ma il formato è solo metà della questione. Un file Parquet perfettamente tipizzato ma pieno di tick sbagliati produce risultati veloci, coerenti e sbagliati. La pulizia viene prima di tutto, e illustriamo un approccio nel nostro test a tre condizioni per gli spike nei dati intraday.
E l'altra metà è la destinazione. Se il tuo test avviene in MetaTrader 4 o 5, finirai comunque per importare CSV, e la nostra guida all'importazione di dati CSV in MT4 mostra i passaggi necessari.
Il nostro punto di vista
Vendiamo dati storici minute-bar puliti, e questa domanda ci arriva spesso da trader che devono decidere come archiviarli e spostarli. Il nostro punto di vista è semplice: il formato del file è un dettaglio di consegna, la qualità dei dati è il prodotto.
Abbiamo visto lo stesso schema ripetersi molte volte. Un trader passa giorni a convertire formati per velocizzare un backtest, e poi scopre che la vera distorsione era una barra difettosa o un aggiustamento non documentato nella fonte. Un formato veloce non può risolvere questo problema. Un CSV pulito caricato in MT4 o MT5 ti darà risultati più affidabili di un file Parquet veloce ma costruito su dati non verificati.
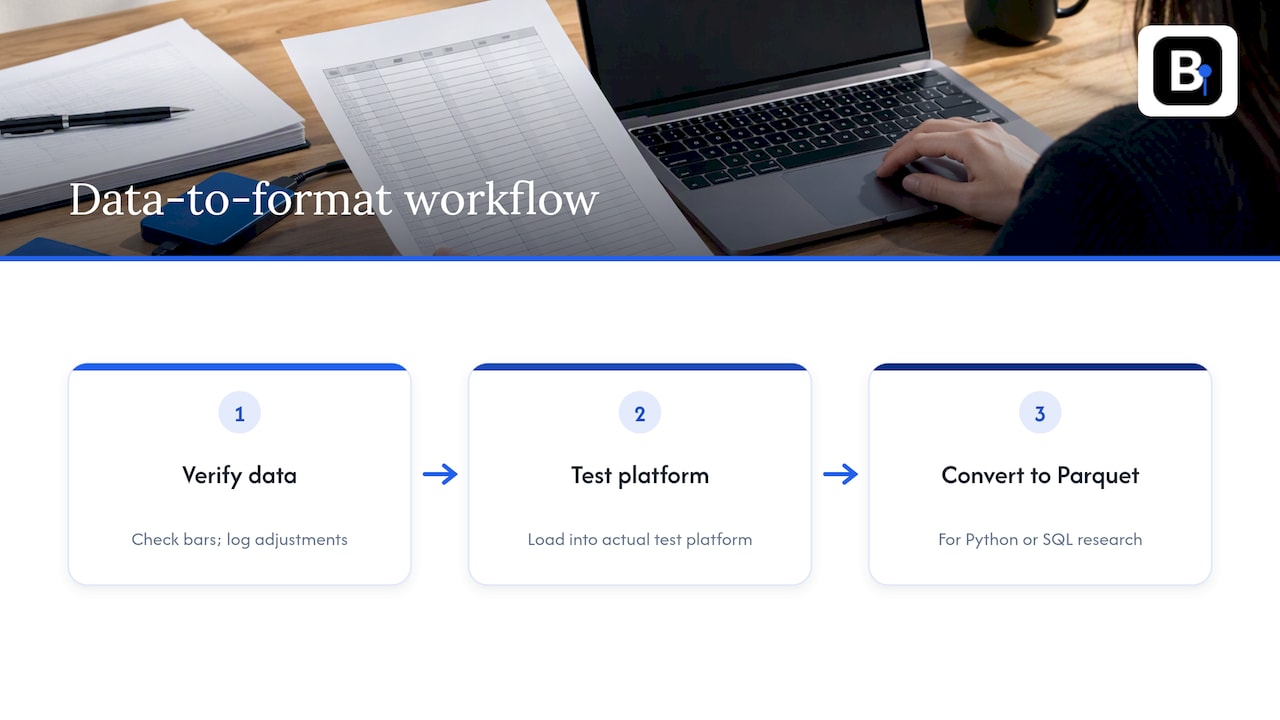
Il nostro consiglio è quindi di ordinare le decisioni in sequenza. Primo, verifica i dati barra per barra e documenta gli aggiustamenti. Secondo, caricali nella piattaforma su cui testi effettivamente. Terzo, se la tua ricerca supera quella piattaforma e passi a Python o a motori SQL, converti una sola volta i dati puliti in Parquet e interroga quella copia. CSV per lo scambio, Parquet per l'analisi, e non saltare mai la pulizia in mezzo.
— Inizia
Dati minute-bar puliti, pronti per l'importazione
Se testi in MT4 o MT5, forniamo dataset minute-bar completi e verificati a partire dal 2014, su forex, metalli, indici azionari e obbligazioni, pronti per l'importazione diretta, con il supporto degli ingegneri che raccolgono i dati. Sfoglia i dataset storici, oppure consulta l'Annual Plan a 119 € all'anno.
Come scegliere: una checklist rapida
- Una persona o uno strumento legacy aprirà questo file? Scegli CSV.
- È sotto alcune centinaia di migliaia di righe e verrà usato una sola volta? Scegli CSV, e risparmia lo sforzo.
- Lo interrogherai ripetutamente, soprattutto un sottoinsieme di colonne o un intervallo di date? Scegli Parquet.
- La coerenza dei tipi conta per i tuoi risultati? Scegli Parquet, oppure un CSV con uno schema documentato che validi al caricamento.
- Il costo di storage o trasferimento è un problema? Scegli Parquet, con ZSTD per gli archivi e Snappy o LZ4 per i dati più "caldi".
6** Il software di destinazione importa solo testo?** Mantieni un'esportazione CSV per quel passaggio.
Una scelta pratica di default: mantieni un'esportazione CSV per lo scambio e una copia Parquet per l'analisi, generate dalla stessa fonte verificata così che le due non divergano mai.
FAQ
Parquet è più leggero di CSV?
Sì, di solito con un ampio margine. In un benchmark su 11,2 milioni di corse taxi, Parquet con ZSTD era 6,8 volte più piccolo del CSV. Il rapporto esatto dipende da quanto sono ripetitivi i tuoi dati.
Qual è la dimensione ideale di un file Parquet?
Per analisi con DuckDB, l'intervallo consigliato è da 100 MB a 10 GB per file. All'interno del file, punta a row group di circa 100K-1M di righe, così le letture possono avvenire in parallelo.
Posso aprire un file Parquet in Excel o in un editor di testo?
Non direttamente. Parquet è binario, quindi serve una libreria come pandas o Arrow, un motore di query come DuckDB, oppure un visualizzatore dedicato. Se devi consegnare dati a qualcuno che lavora con i fogli di calcolo, esporta un CSV.
Devo comprimere di nuovo un file Parquet con gzip?
No. Parquet applica già la propria compressione, quindi comprimere il file con gzip aggiunge un costo di CPU a ogni lettura per un risparmio di spazio quasi nullo. Scegli invece il codec giusto al momento della scrittura del file.
Fonti
- Apache Parquet
- Configurations | Parquet
- File Formats | DuckDB
- A Deep Dive into Apache Parquet with ClickHouse, Part 2
- CSV vs Parquet Benchmark | MotherDuck
- Columnar File Performance Check-in for Python and R | Ursa Labs
- Data formats in analytical DBMSs | The VLDB Journal
- Comma-separated values | Wikipedia
Consigliati
- Formati di dati di mercato per sviluppatori e quant: SBE, Parquet, Dollar Bars
- Come importare dati CSV in MT4 per il backtesting
- Fermare le candele spezzate in due minuti quando importi CSV in MT5
Risorse correlate
Esplora la guida di BacktestMarket su come importare dati in MetaTrader per mettere in pratica le idee di questo articolo.