Il look ahead bias si verifica quando un test storico utilizza informazioni che non sarebbero state disponibili nel momento della decisione, facendo apparire un backtest o una previsione molto migliore di quanto il trading live potrà mai essere. Se costruisci strategie, addestri modelli su serie temporali o rivedi ricerche finanziarie, devi sapere dove si nasconde e come eliminarlo prima di fidarti di qualsiasi risultato.
TL;DR:
- Suddividi le serie temporali in ordine cronologico e adatta scaler, encoder, feature selector e altre trasformazioni apprese solo su ciascuna finestra di training, mai sull'intero campione.
- Usa le date di pubblicazione anziché le date di riferimento per i dati macroeconomici e contabili, e usa i record vintage quando revisioni successive potrebbero cambiare ciò che era originariamente noto.
- Rilancia i test storici con dati troncati o input ritardati; i segnali precedenti dovrebbero rimanere invariati, mentre la performance reale dovrebbe indebolirsi gradualmente anziché crollare.
- Registra il timestamp più recente di ogni segnale e verifica che non superi il momento della decisione; mantieni intatto il periodo di test finale durante la selezione del modello.
Indice
- Cos'è il look ahead bias e come si manifesta in un esempio semplice
- Dove si nasconde il leakage nei backtest e nelle pipeline di machine learning
- Come individuare il look ahead bias in un backtest che hai già
- Come prevenire il look ahead bias prima che entri nella tua pipeline
- Una checklist di audit da eseguire prima di fidarti di un backtest
- Perché i buffer rolling e i protocolli pubblicati rendono la prevenzione strutturale
- Perché questo è importante per la credibilità della ricerca
- Dati minute-bar più puliti eliminano diverse trappole di look ahead
- FAQ
- Fonti
Cos'è il look ahead bias e come si manifesta in un esempio semplice
Il look ahead bias significa che una decisione al tempo t dipende silenziosamente da dati arrivati solo dopo t. La strategia "sapeva" qualcosa che non avrebbe potuto sapere, quindi il risultato storico è fittizio. Qualsiasi input, trasformazione o scelta del modello che utilizzi informazioni non disponibili al momento di origine della previsione conta come leakage.
Immagina un indicatore costruito a partire da una media mobile centrata. Il martedì fa la media di lunedì, martedì e mercoledì, eppure il tuo backtest tratta quel valore come noto il martedì mattina. Ogni segnale sembra quindi anticipare il movimento di domani.
Questi confronti aiutano a riconoscere il sintomo:
- Rispetto all'hindsight bias: l'hindsight bias è un errore umano di memoria ("lo sapevo già"), mentre il look ahead bias è un difetto meccanico nel modo in cui il test è costruito.
- Rispetto all'overfitting: l'overfitting adatta un modello troppo strettamente al rumore presente nei dati che gli è consentito vedere, mentre il look ahead bias fornisce al modello dati che non dovrebbe mai vedere.
- Il segnale rivelatore: risultati che sembrano troppo puliti, con equity curve lisce e quasi nessuna serie di perdite, meritano sospetto prima di celebrazione.
Dove si nasconde il leakage nei backtest e nelle pipeline di machine learning
La maggior parte del leakage non è esotica. Deriva da comodità ordinarie nella scrittura del codice e nella gestione dei dati, e tende a concentrarsi sempre negli stessi punti:
- Preprocessing sull'intero campione: scaling, normalizzazione o PCA applicati prima della suddivisione train/test permettono alle statistiche del periodo di test di influenzare le feature di training. Il leakage di dati spesso si verifica quando i passaggi di preprocessing vengono adattati su tutti i dati, quindi l'abitudine sicura è dividere prima.
- Finestre proiettate in avanti: smoothing centrato, timestamp disallineati e bar giornalieri uniti a segnali intraday senza rispettare gli orari di chiusura delle bar.
- Sbirciatine durante la selezione: scegliere feature o iperparametri usando il periodo di test finale, per poi riportare quello stesso periodo come out-of-sample.
- Dati rivisti: dati macro e contabili che sono stati rettificati o aggiornati retroattivamente dopo la loro pubblicazione originale. Le revisioni contabili e i disallineamenti temporali tra fondamentali poco frequenti e prezzi giornalieri creano bias a meno che timestamp e aggiustamenti non vengano gestiti in modo coerente.
- Errori di indicizzazione: operazioni vettorializzate in pandas o numpy con uno spostamento off-by-one che legge la riga di domani.
Anche i praticanti più attenti cadono in questo errore. Previsori ben intenzionati possono introdurre involontariamente look-ahead bias tramite intuizione o pattern appresi dal campione di test, il che gonfia la performance riportata.
Nota statistica: i fold di cross-validation casuali su serie temporali possono far trapelare informazioni future e produrre una valutazione eccessivamente ottimistica, motivo per cui la suddivisione consapevole del fattore temporale è la raccomandazione standard.
Come individuare il look ahead bias in un backtest che hai già
Non serve ricostruire tutto per verificare la presenza di contaminazione. Inizia con queste verifiche, all'incirca in ordine di impegno:
- Tronca la storia. Rilancia il backtest su dati interrotti a una data precedente. I segnali prima del cutoff dovrebbero essere identici alla run completa. Se cambiano, la strategia sta usando dati successivi.
- Sposta e blocca. Ritarda i tuoi input di una bar, oppure oscura completamente i giorni successivi. Un vantaggio reale si degrada in modo graduale. Uno trapelato collassa.
- Confronta con una run limitata. Registra i valori degli indicatori e il timing di entrata/uscita dalla run completa, poi confrontali con una run in cui il motore può vedere solo i dati fino a ciascun punto di decisione. Qualsiasi discrepanza indica esattamente la riga di codice da controllare.
- Verifica il preprocessing. Conferma che ogni scaler, encoder, selector e imputer sia adattato solo sui dati di training. Adatta sul training set, poi trasforma il test set, mai il contrario.
- Diffida dell'eccellenza uniforme. Se decine di varianti di strategia performano tutte in modo sospettosamente bene, la causa più probabile è il dato o la pipeline comune, non la vostra genialità collettiva.
Consiglio pratico: Registra il timestamp della riga di dati più recente usata per ogni singolo segnale, poi verifica nel codice che non superi mai il momento della decisione. Un'asserzione fallita vale più di settimane di dubbi.
Per strutturare le finestre di validazione, la nostra guida walk-forward sulle buone pratiche di backtesting ripercorre passo dopo passo la meccanica.
Come prevenire il look ahead bias prima che entri nella tua pipeline
L'individuazione è una pulizia. La prevenzione costa meno, e si riduce a poche abitudini da integrare in ogni progetto.
- Dividi per tempo, non a caso. Usa validazione walk-forward o a finestra espandibile in modo che ogni fold si addestri sul passato e venga testato sul futuro. La suddivisione consapevole del fattore temporale, anziché casuale, è l'approccio raccomandato per le serie temporali.
- Adatta sul training, trasforma sul test. Ogni parametro appreso, da una media a un loading di PCA, deve provenire solo dalla finestra di training.
- Vincola i passaggi in una pipeline. Inserisci scaling e feature selection all'interno del fold di training in modo che non possano vedere al di fuori di esso.
- Rispetta i ritardi di pubblicazione. Allinea la data di disponibilità di ogni predittore, non la sua data di riferimento, al momento della decisione, e usa dati vintage dove esistono revisioni.
- Rendi impossibile l'accesso al futuro. Preferisci buffer rolling e fasi di warmup che espongono solo i tick passati.
- Documenta le prove. Per ogni previsione storica, salva il momento della decisione, gli input grezzi e le trasformazioni.
| Pratica | Cosa blocca |
|---|---|
| Suddivisioni walk-forward | Addestramento su osservazioni future |
| Adattamento solo sul training | Fuga delle statistiche di test nelle feature |
| Dati vintage | Utilizzo di cifre riviste prima della pubblicazione |
| Buffer rolling e warmup | Accesso diretto a righe future |
| Log delle decisioni | Risultati non verificabili |
Consiglio pratico: Tratta il tuo periodo di test come una risorsa monouso. Ogni sguardo che vi getti e che influenza una decisione ne consuma parte della credibilità.
Le nostre guide su dati MT5 dal walk-forward all'out-of-sample e sulla preparazione dei dati con audit dei gap anno per anno trattano nel dettaglio l'aspetto dei dati di questo lavoro.
Una checklist di audit da eseguire prima di fidarti di un backtest
Incollala in un README del repository o in una revisione pre-rilascio. Ogni punto richiede una risposta scritta, non un cenno mentale di assenso.
- Momento della decisione: indica quando si assume venga presa ogni previsione o operazione.
- Target: definisci l'esatto esito futuro e il suo orizzonte temporale.
- Input grezzi: elenca quali campi erano effettivamente osservabili a quel momento decisionale.
- Trasformazioni: conferma che ogni passaggio di adattamento e selezione abbia usato solo dati di training.
- Costruzione delle feature: conferma che lag e finestre non tocchino mai righe future.
- Selezione del modello: conferma che il test set non sia mai stato sbirciato o riutilizzato durante il tuning.
- Vintage dei dati: documenta come sono state gestite revisioni e aggiornamenti retroattivi.
Se una risposta è "credo di sì", trattala come un fallimento finché non puoi dimostrarla. Il nostro articolo sui controlli di cui i quant hanno bisogno per i dati di backtesting si abbina bene a questa lista.
Perché i buffer rolling e i protocolli pubblicati rendono la prevenzione strutturale
La disciplina manuale fallisce sotto la pressione delle scadenze, quindi le difese più solide sono integrate nel sistema. Un'architettura a buffer rolling espone a ciascun operatore solo i tick passati e usa un warmup automatico, rendendo l'accesso look-ahead strutturalmente impossibile anziché semplicemente scoraggiato. Il warmup impedisce inoltre a una strategia di fare trading prima di avere abbastanza storico.
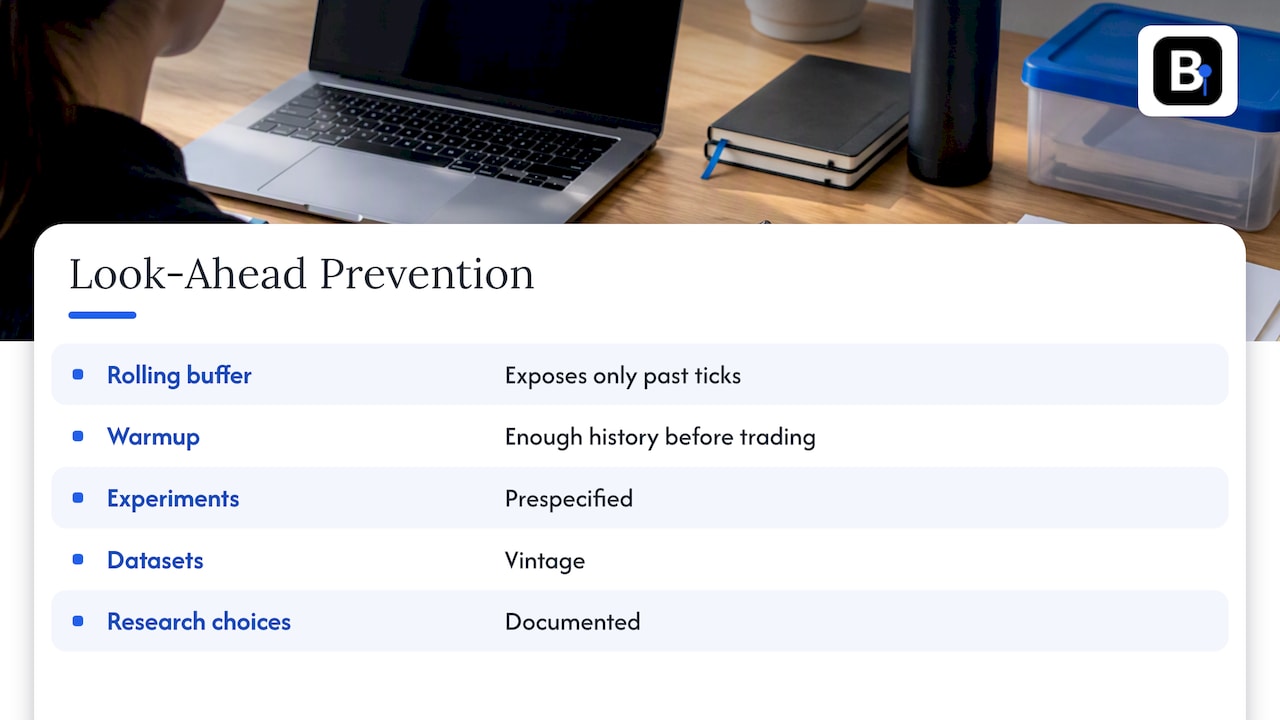
Sul fronte della ricerca, un protocollo di backtesting per l'era del machine learning raccomanda esperimenti prespecificati, dataset vintage e scelte documentate. Insieme, questi elementi si mappano direttamente sui passaggi di individuazione e prevenzione descritti sopra.
Perché questo è importante per la credibilità della ricerca
Il leakage e i test ripetuti alimentano la stessa trappola: la maledizione del vincitore. Provando abbastanza varianti, la migliore sembrerà brillante in parte per fortuna, e le informazioni trapelate gonfiano ulteriormente quella fortuna. Lo stesso lavoro sul protocollo nota che il vero out-of-sample è il trading live, il che dovrebbe rendere umile chiunque mostri una bella equity curve.
Il mio punto di vista è semplice: prespecifica la tua ipotesi, mantieni il modello semplice quanto il problema lo consente, e dedica lo sforzo ingegneristico a controlli strutturali invece di fidarti di ricordare ogni verifica.
— Start
Dati minute-bar più puliti eliminano diverse trappole di look ahead
Molti problemi di leakage iniziano con input disordinati: timestamp disallineati, gap e aggiustamenti silenziosi. I nostri set minute-bar sono puliti, documentati e pronti da importare in MT4 e MT5, così puoi dedicare il tuo impegno alla strategia invece che all'idraulica dei dati. Esplora la nostra pagina Dati Storici, oppure dai un'occhiata al Piano Annuale per un accesso continuativo.
FAQ
Cos'è il look ahead bias?
Il look ahead bias è l'utilizzo, in un test storico, di informazioni che non sarebbero state note al momento della decisione. Fa apparire backtest e previsioni migliori di quanto il trading reale possa effettivamente offrire. Il poster di data science della Columbia sulle previsioni dei rendimenti azionari mostra come i modelli possano apparire a conoscenza di rendimenti successivi agli eventi.
Cosa significa "look ahead" in un backtest?
Significa che il test legge dati successivi al punto di decisione simulato, come la chiusura di una bar futura o una revisione successiva di un dato. La strategia reagisce quindi a qualcosa che non avrebbe potuto vedere. Qualsiasi lettura di questo tipo rende il risultato inaffidabile.
In cosa differisce l'hindsight bias dal look ahead bias?
L'hindsight bias è una tendenza psicologica a credere che gli eventi passati fossero prevedibili. Il look ahead bias è un errore tecnico in cui dati futuri entrano in un calcolo. Il primo risiede nella tua mente, il secondo nel tuo codice e nei tuoi dati.
Come posso fermare il look ahead bias nel forecasting di serie temporali?
Suddividi i dati in ordine cronologico, adatta tutto il preprocessing solo sulle finestre di training, e usa pipeline in modo che i passaggi di selezione restino all'interno di ciascun fold. Toolkit di forecasting come sktime segnalano le insidie del confondere il forecasting con la normale regressione supervisionata.
Fonti
- Lagged features for time series forecasting — scikit-learn 1.9.1 documentation
- Lookahead Bias Prevention - Clypt
- A Backtesting Protocol in the Era of Machine Learning
- 12. Common pitfalls and recommended practices — scikit-learn 1.9.1 documentation
- Look-Ahead Bias and Data Leakage – SlackQuant Research
Consigliati
- Stop Fake Alpha: 5 Checks Quants Need for Hedging Backtesting Data
- Data Snooping Bias: How Researchers and Quants Catch It
- 99% Modeling Quality for Quants: MQL4 Data Prep Per Year Gap Audit
Risorse correlate
Esplora i pacchetti di dati storici di BacktestMarket per mettere in pratica le idee di questo articolo.