Il version control dei dataset significa registrare esattamente da quali dati è stato costruito un risultato, in modo da poterlo ricostruire mesi dopo e ottenere gli stessi numeri. Per un trader, questo significa che ogni backtest fa riferimento a uno snapshot fisso e identificabile della propria serie storica di prezzi, non a una cartella che è cambiata silenziosamente. Di seguito: gli strumenti, una struttura che funziona, cosa registrare e le trappole specifiche dei dati di mercato.
TL;DR
- Versiona insieme i dati, il codice, i parametri e l'output. Versionare solo i file è metà del lavoro.
- Tieni i file di grandi dimensioni fuori da Git puro. Usa uno strumento basato su puntatori come DVC, o quanto meno snapshot immutabili, con hash e di sola lettura.
- Tratta ogni correzione del vendor, regola di rollover o passaggio di pulizia come una nuova versione del dataset, con un changelog scritto.
- Il ragionamento point-in-time conta: un dataset revisionato silenziosamente o filtrato per survivorship renderà il tuo backtest artificiosamente migliore.
- Non sovrascrivere mai un dataset. Aggiungi una nuova versione e conserva quella vecchia per gli audit.
Indice
- Cosa risolve davvero il version control dei dataset
- Perché Git puro è il posto sbagliato per i dati di mercato
- Le quattro cose da versionare insieme
- Una struttura di cartelle e nomenclatura che regge
- Cosa inserire nel changelog
- Le trappole dei dati di mercato che il versioning mette in luce
- Passo dopo passo: una configurazione minima in un pomeriggio
- Collegare le versioni ai risultati live
- Il nostro punto di vista
- Partire da una base pulita e pronta all'importazione
- Errori comuni da evitare
- FAQ
- Fonti
Cosa risolve davvero il version control dei dataset
I team di sviluppo software hanno risolto questo problema per il codice decenni fa. I dataset sono più difficili perché sono voluminosi, binari e spesso sostituiti sul posto. Scarichi un nuovo file di barre al minuto, lo sovrascrivi a quello vecchio, rilanci la strategia e l'equity curve è diversa. Era il codice? I parametri? I dati? Senza versioni non puoi saperlo.
Dovrebbe sempre essere possibile rispondere a tre domande:
- Quali dati esatti hanno prodotto questo risultato?
- Cosa è cambiato tra questo dataset e quello precedente?
- Posso rieseguire l'esperimento e ottenere lo stesso output?
La guida utente di DVC inquadra l'obiettivo come riproducibilità: descrive uno strumento open-source per la gestione dei dati, l'automazione delle pipeline e la gestione degli esperimenti che aiuta i team a gestire grandi dataset e rendere i progetti riproducibili. La stessa guida descrive il lavoro basato su tre principi: metafile leggibili dall'uomo, versioning tramite Git e collaborazione sui dati basata sul cloud.
Perché Git puro è il posto sbagliato per i dati di mercato
Git è eccellente per il testo. Un insieme pluriennale e multi-strumento di barre al minuto non è né piccolo né facile da gestire come testo. Caricare dati grezzi in un repository lo appesantisce e rallenta tutto, e le piattaforme di hosting impongono limiti di dimensione sui repository. La documentazione di DVC descrive l'alternativa: il repository Git contiene piccoli file puntatore con hash e metadati, mentre i file pesanti risiedono in storage esterno come S3 o GCS.
Questa idea del puntatore è il nucleo della maggior parte degli strumenti di version control per dataset:
- Git versiona il puntatore, il codice e la configurazione.
- Lo storage remoto contiene i byte effettivi, indirizzati tramite hash del contenuto.
- Un comando di checkout ripristina i dati corrispondenti a un determinato commit.
Se non l'hai mai usato, il tutorial DVC sul versioning di dati e modelli illustra passo passo la gestione pratica di più dataset e modelli.
Una breve storia che spiega il design
I vecchi sistemi centralizzati si basavano sul blocco dei file e su una connessione costante al server. La panoramica di Kitware sul distributed version control descrive come i sistemi distribuiti li abbiano spodestati grazie a repository concorrenti e al funzionamento senza rete. Per i tuoi dati questo conta in un modo molto pratico: vuoi che ogni macchina di ricerca possieda una storia completa e verificabile, senza dipendere da un'unica unità condivisa che qualcuno può sovrascrivere.
Cosa non è il version control
I project tracker non sono version control dei dataset. Jira, ad esempio, collega gli issue a versioni di rilascio come 1.0 o 2.1.1, ma non memorizza né versiona i file di dati o di codice veri e propri. Usalo pure per le attività, se vuoi. Non ti dirà mai quale CSV ha alimentato il test di martedì scorso.
Le quattro cose da versionare insieme
Uno snapshot del dataset da solo non rende riproducibile un backtest. La visione d'insieme della guida DVC è che bisogna versionare gli input grezzi, ma anche i parametri di configurazione, gli script di elaborazione e i modelli risultanti. Per un quant, questo si traduce in quattro livelli:
| Livello | Esempi | Come versionarlo |
|---|---|---|
| Dati grezzi | Barre al minuto per simbolo, tabelle di rollover | Snapshot con hash, di sola lettura, tracciati tramite file puntatore |
| Elaborazione | Script di pulizia, resampling, conversione di fuso orario | Git, taggato con la versione dei dati |
| Parametri | Spread, commissioni, slippage, input della strategia | File di configurazione in Git |
| Risultati | Liste di trade, equity curve, report della piattaforma | Archiviati per singola esecuzione, nominati con commit e versione dei dati |
La stessa logica ti fornisce una traccia di audit. Se un risultato sembra troppo buono, puoi ripercorrere ogni livello e scoprire quale si è mosso.
Una struttura di cartelle e nomenclatura che regge
Non serve un'infrastruttura pesante fin dal primo giorno. Questa struttura funziona con o senza uno strumento dedicato:
project/
  data/
    raw/          # mai modificato, una cartella per versione
      v2026.10/
      v2026.07/
    processed/    # generato solo dagli script
  config/         # spread, costi, orari di sessione
  src/            # codice di pulizia e della strategia
  results/        # una sottocartella per ogni esecuzione
  CHANGELOG.md    # cosa è cambiato in ogni versione dei dati
Regole che mantengono tutto onesto:
- I dati grezzi sono di sola lettura. Se una barra sembra errata, la correggi in uno script che scrive in
processed, e lo script stesso è versionato. - Versiona per data o contatore, mai con "final" o "new". Nomi come
final_v2_REALsono proprio il problema che il version control esiste per prevenire. - Registra un checksum. Un hash SHA-256 per file, memorizzato in un manifest, dimostra che il file non è cambiato.
- Timbra ogni risultato. Ogni esecuzione scrive nel proprio report il commit del codice, la versione dei dati e l'hash della configurazione.
Cosa inserire nel changelog
Un changelog dei dati è breve e specifico. Per ogni nuova versione, annota:
- Data del download e fonte.
- Strumenti e intervallo di date coperto.
- Fuso orario e convenzione di sessione.
- Eventuali barre rimosse, riparate o interpolate, e il motivo.
- Metodo di roll dei contratti o di back-adjustment per serie di tipo futures.
- Differenze rispetto alla versione precedente, come uno spike corretto o un gap colmato.
Se effettui tu stesso la pulizia, documenta la regola oltre al risultato. La nostra analisi di uno spike test per la pulizia dei dati intraday mostra il tipo di regola esplicita e ripetibile che appartiene a questo log, e la checklist in 7 passi per l'audit dei dati su MT4 e MT5 è una lista sensata da seguire prima di contrassegnare una versione come affidabile.
Le trappole dei dati di mercato che il versioning mette in luce
Revisioni silenziose e look-ahead bias
I dati possono cambiare a posteriori. Le cifre fondamentali vengono ridichiarate e i prezzi vengono corretti. Se il tuo backtest usa il valore rivisto per una data in cui esisteva solo quello originale, conosce il futuro. Il paper sul protocollo di backtesting di Campbell Harvey osserva che dati veramente out-of-sample non esistono quando la storia è finita e nota, il che è un motivo per essere rigorosi su ciò che un modello avrebbe potuto effettivamente vedere in ogni punto.
L'articolo Seven Sins of Quantitative Investing descrive il rimedio ideale come un database point-in-time, in cui il vendor archivia i dati così come originariamente riportati, con le date di comunicazione, e traccia le revisioni successive. La tua storia delle versioni svolge la stessa funzione a livello di file: la versione 2026.07 è ciò che sapevi a luglio, e resta tale.
Survivorship bias
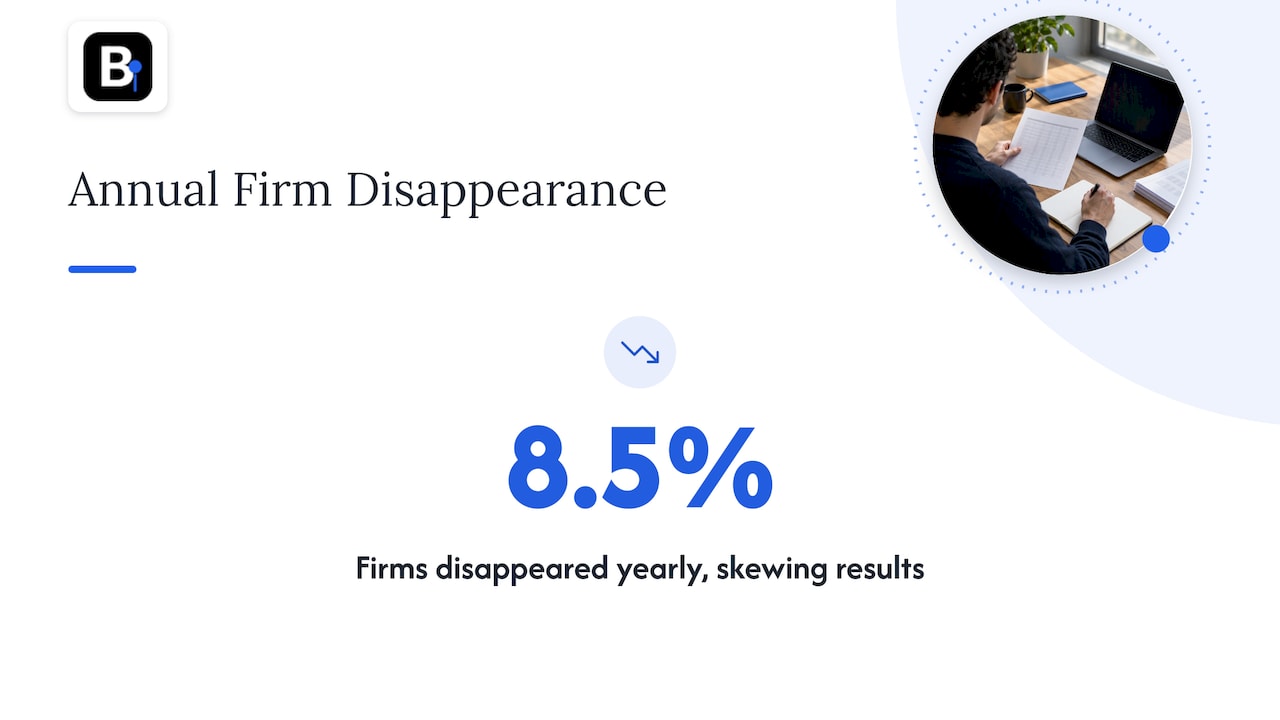
Se un dataset contiene solo strumenti ancora esistenti, i fallimenti scompaiono e i risultati vengono gonfiati. Uno studio su un database di dati fondamentali ampiamente utilizzato ha riportato che circa l'8,5% delle aziende è scomparso ogni anno tra il 1980 e il 2018, quindi ometterle distorce i risultati. L'articolo Your Backtest Is Cheating sostiene che uno screening storico è una query as-of su un sistema di dati versionato, non un filtro su righe, e mette in guardia sui ticker riutilizzati. Questo è il modello mentale corretto per qualsiasi dataset tu mantenga.
Per il forex, i metalli e le barre al minuto degli indici, la survivorship è meno un problema rispetto a gap, timestamp, gestione dei rollover e spike. Il principio è identico: sapere esattamente cosa contiene il file e mantenere questa conoscenza legata a una versione.
Modifiche silenziose nello stesso nome file
Il fallimento più comune nella pratica è banale. Un file viene aggiornato, un fuso orario viene spostato, un gap viene colmato e nessuno lo registra. Il nostro articolo sulle fonti di dati intraday che i trader devono auditare copre cosa controllare quando una fonte cambia, e l'audit dei gap anno per anno nella preparazione dei dati MQL4 mostra come una visione anno per anno riveli buchi che una cifra di qualità complessiva nasconde.
Passo dopo passo: una configurazione minima in un pomeriggio
- Crea un repository Git per codice, configurazione e changelog.
- Inizializza uno strumento di tracciamento dati come DVC, e aggiungi la tua cartella di dati grezzi. Lo strumento scrive piccoli file puntatore che tu commit su Git.
- Configura lo storage remoto, che sia un bucket cloud o un'unità di rete, e carica i dati.
- Tagga il commit con la versione dei dati, ad esempio
data-2026.10. - Definisci la tua pipeline (pulizia, resampling, backtest) come fasi scriptate, in modo che gli output si rigenerino dagli input.
- Scrivi il manifest: nomi dei file, dimensioni, hash, intervallo di date.
- Esegui un backtest di baseline e memorizza il suo report sotto il tag.
- Quando i dati cambiano, aggiungi una nuova versione, aggiorna il changelog, riesegui la baseline e confrontala con il report precedente prima di fidarti di qualsiasi nuovo risultato.
Il passo 8 è quello che le persone saltano. Rieseguire una baseline fissa su ogni nuova versione dei dati ti dice immediatamente se i dati hanno spostato i tuoi numeri.
Collegare le versioni ai risultati live
I dati versionati sono anche ciò che ti permette di confrontare un backtest con quanto accaduto in produzione. Se i due divergono, devi escludere prima i dati, poi i costi, poi l'esecuzione. Un confronto tra backtest e trading live su 200 trade verificati mostra il tipo di corrispondenza tra segnale e fill che questo richiede, e funziona solo se il lato backtest può essere riprodotto esattamente. Anche i costi appartengono alla configurazione versionata, motivo per cui suggeriamo di testare tre regimi di costi di transazione come configurazioni separate e nominate.
Il nostro punto di vista
Raccogliamo e manteniamo dati a barre al minuto, e vediamo lo stesso schema ripetersi nelle conversazioni di supporto: la strategia di un trader "ha smesso di funzionare" dopo un aggiornamento dei dati, e nessuno riesce a dire cosa sia cambiato. La causa è raramente esotica. Di solito è una differenza non documentata tra due file.
Ecco perché verifichiamo i nostri dataset barra per barra, documentiamo gli aggiustamenti e manteniamo i dataset pronti per l'importazione diretta in MT4 e MT5. Un dataset pulito è la base, ma è il version control a mantenerlo affidabile nel tempo. La nostra opinione:
- Non sostituire mai un dataset sul posto. Aggiungi una versione.
- Una regola di pulizia che non puoi scrivere è una regola che non puoi riprodurre.
- Gli standard di qualità dei dati dovrebbero valere allo stesso modo per i ricercatori umani e per il backtesting automatizzato guidato dall'AI, perché un modello farà volentieri overfitting su un difetto.
- Riesegui una baseline dopo ogni modifica dei dati. Richiede pochi minuti e previene settimane di confusione.
— Start
Partire da una base pulita e pronta all'importazione
Il versioning aiuta solo se la prima versione è solida. Se preferisci non pulire da solo i feed grezzi, i nostri dataset storici coprono forex, metalli, indici azionari, obbligazioni e materie prime come barre al minuto dal 2014, pronti per l'importazione in MT4 e MT5. Puoi sfogliare i dati forex o gli indici azionari direttamente. Il nostro Piano Annuale è proposto a 119 EUR all'anno. Scarica un set, archivialo come tua prima versione immutabile, registra il suo hash e inizia da lì il tuo changelog.
Errori comuni da evitare
- Versionare solo il codice della strategia. I dati determinano il risultato tanto quanto la logica.
- Archiviare i risultati senza i relativi input. Un'equity curve senza versione dei dati è un aneddoto.
- Modificare i file grezzi a mano. Anche una correzione di una sola barra richiede uno script e una voce di log.
- Mescolare fusi orari tra le versioni. Registra la convenzione ogni volta.
- Conservare solo l'ultima versione. Perdi la capacità di spiegare i risultati passati.
- Saltare i controlli a livello di portafoglio. I test multi-strumento moltiplicano i punti in cui i dati possono derivare, come mostrato nella nostra guida al backtesting di portafoglio su MT4 con replay dell'export.
FAQ
Qual è la differenza tra Git e gli strumenti di version control per dataset?
Git traccia le modifiche al testo riga per riga e fatica con i file binari di grandi dimensioni. Strumenti per dataset come DVC conservano in Git piccoli file puntatore con gli hash e memorizzano i dati pesanti in storage esterno. Ottieni lo stesso flusso di commit e checkout senza appesantire il repository.
Jira è uno strumento di version control?
No. Jira è un tracker di progetti e issue che può raggruppare gli issue in versioni di rilascio, ma non memorizza né versiona i file di dati o di codice. Per questo compito usa Git, abbinato a uno strumento basato su puntatori per i dati di grandi dimensioni.
Come si faceva il version control prima di Git?
Si usavano sistemi centralizzati come CVS e Subversion, che seguivano strumenti precedenti basati sul blocco come RCS. Questi richiedevano tipicamente una connessione a un server centrale, motivo principale per cui i sistemi distribuiti li hanno sostituiti nella maggior parte del lavoro di sviluppo.
Serve uno strumento dedicato, o bastano cartelle datate?
Per un trader solo con pochi dataset, cartelle datate di sola lettura, un manifest di hash e un changelog sono un buon punto di partenza. Passa a uno strumento dedicato quando condividi i dati tra più macchine o persone, o quando vuoi pipeline che ricostruiscano automaticamente i risultati.
Fonti
- User Guide, Data Version Control
- Tutorial: Data and Model Versioning, DVC
- Distributed Version Control: The Future of History, Kitware
- Jira (software), Wikipedia)
- A Backtesting Protocol in the Era of Machine Learning, Campbell Harvey
- Seven Sins of Quantitative Investing
- Your Backtest Is Cheating
Consigliato
Risorse correlate
Scopri gli Expert Advisor robots di BacktestMarket per mettere in pratica le idee di questo articolo.