Per fare il resampling dei dati al minuto, chiama df.resample(rule).agg(OHLCV_AGG) con open=first, high=max, low=min, close=last e volume=sum. Localizza prima i timestamp nel fuso orario dell'exchange, poi ancora i bucket con origin o offset in modo che le bar a 5 minuti inizino dove i grafici se le aspettano. Conta le righe di origine in ogni bucket ed elimina o segnala quelle incomplete, invece di fare un forward-fill cieco dei prezzi OHLC.
TL;DR:
- Usa first open, maximum high, minimum low, last close e volume sommato; elimina i bucket vuoti perché non contengono un prezzo di chiusura reale.
- Converti i timestamp nel fuso orario dell'exchange prima del resampling, poi imposta origin o offset per allineare i bucket alla griglia del grafico della sessione.
- Conta le righe di origine per bucket e segnala le bar incomplete; eliminale per i backtest, ma conservale con un flag is_partial per grafici o input di modelli.
- Quando è necessario riempire i gap, imposta Open dal Close precedente, metti Volume mancante a zero, e ricostruisci High e Low a partire da Open e Close.
- Imposta closed e label in modo esplicito: i minuti timbrati all'apertura di solito usano i bordi sinistri, mentre i minuti timbrati alla chiusura di solito usano i bordi destri; i segnali dovrebbero usare solo bar completate.
Indice
- Ricetta pandas pronta all'uso per il resampling dei dati OHLCV al minuto
- Come allineare i bucket: origin, offset, modulo snap e fusi orari
- Rilevare e gestire i minuti mancanti con bar_count
- Strategie di riempimento che mantengono logiche le candele OHLC
- Come label e closed cambiano il contenuto dei bucket
- Checklist pre-volo prima di fare il backtest delle bar risultanti dal resampling
- Esempio completo: da 1min a 5min, 15min e 1h con gestione dei dati parziali
- Perché conserviamo i minuti grezzi e facciamo il resampling più tardi
- Bar al minuto pronte all'importazione da BacktestMarket
- FAQ
- Fonti
Ricetta pandas pronta all'uso per il resampling dei dati OHLCV al minuto
Il metodo resample di pandas richiede un DatetimeIndex, oppure una colonna on che contenga i timestamp. Definisci la mappa di aggregazione una sola volta e riutilizzala per ogni frequenza di destinazione:
import pandas as pd

OHLCV_AGG = {
    "open": "first",
    "high": "max",
    "low": "min",
    "close": "last",
    "volume": "sum",
}

bars_5m = df.resample("5min").agg(OHLCV_AGG)
bars_5m = bars_5m.dropna(subset=["close"])
Segui questo schema ogni volta:
- Assicurati che l'indice sia un DatetimeIndex ordinato, oppure prevedi di passare
on="timestamp". - Applica
.resample(rule).agg(OHLCV_AGG)con la stessa mappa per ogni frequenza. - Elimina le finestre vuote con
dropna(subset=["close"]), perché un bucket senza trade non ha un close. - Aggiungi una colonna di qualità come
bar_countprima di fidarti del risultato (ne parliamo meglio più avanti).
Se i timestamp risiedono in una colonna, la chiamata cambia solo leggermente:
bars_5m = df.resample("5min", on="timestamp").agg(OHLCV_AGG)
Funziona, ma è più lento e più facile da sbagliare rispetto alla versione con l'indice. Quando carichi i dati, esegui df = df.set_index("timestamp").sort_index() una volta sola, poi fai il resampling dall'indice ovunque in seguito.
Suggerimento: Mantieni i nomi delle colonne in minuscolo e coerenti in tutta la pipeline, così un unico dict OHLCV_AGG serve per ogni dataset e ogni frequenza.
Come allineare i bucket: origin, offset, modulo snap e fusi orari
Il resampling è in realtà un riallineamento. Se i tuoi bucket a 5 minuti deviano dalla griglia 09:30, 09:35, 09:40, le bar non corrispondono più a nessun grafico con cui le confronti. La documentazione di resample descrive origin e offset come i controlli per l'allineamento dei bin, e la guida utente sulle serie temporali mostra come origin='start' e origin='end' cambino il punto di partenza della griglia.
origin="start_day"(l'impostazione predefinita) ancora la griglia alla mezzanotte del primo giorno, il che si adatta alla maggior parte del lavoro intraday.origin="start"ancora al primo timestamp, quindi un dataset che inizia alle 09:31 avrà bucket che partono dalle 09:31.origin="end"o"end_day"ancora all'ultimo timestamp o all'ultima mezzanotte, utile quando costruisci le bar a ritroso partendo dai dati più recenti.- Un offset sposta ogni confine, comodo quando una sessione apre fuori dall'ora esatta e vuoi bar orarie allineate a quella sessione.
Per dati con timestamp in epoch, uno snap modulo ti dà una griglia che non dipende da nessuna logica di origin:
step = 300  # secondi in una bar da 5 minuti
df["bucket"] = (df["epoch"] // step) * step
bars = df.groupby("bucket").agg(OHLCV_AGG)
bars.index = pd.to_datetime(bars.index, unit="s", utc=True)
I fusi orari contano altrettanto. Localizza nel fuso orario dell'exchange prima del resampling, ad esempio df.index.tz_localize("UTC").tz_convert("America/New_York"). Una guida sulla gestione dei fusi orari avverte che saltare questo passaggio causa drift della sessione e confini giornalieri disallineati. Il nostro approfondimento su come correggere gli errori DST nei dati al minuto mostra come il problema emerge nella pratica.
La regola generale: localizza prima, fai il resampling dopo, mai il contrario.
Rilevare e gestire i minuti mancanti con bar_count
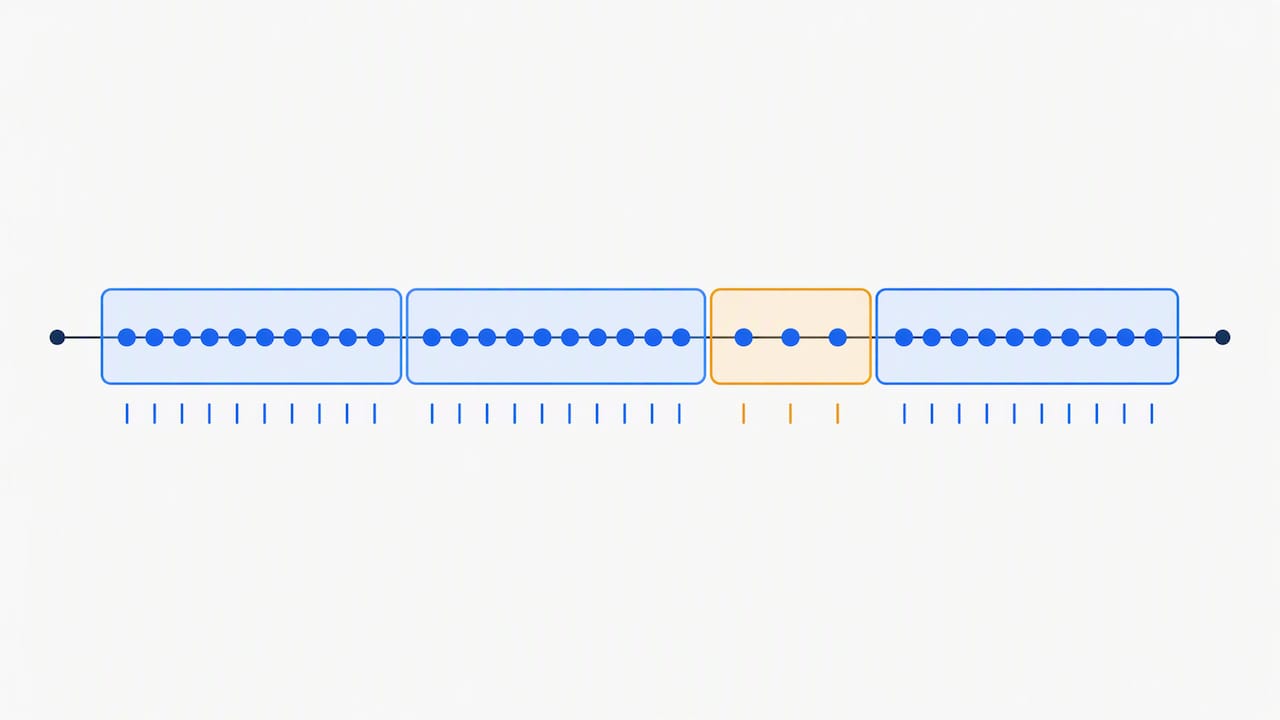
I dati al minuto hanno dei gap, e non tutti sono errori. Gli strumenti poco liquidi spesso mancano di bar nei minuti tranquilli, e il riferimento di pandas sul resampling è un buon punto di partenza quando devi ispezionare come si formano i bucket. Se fai forward-fill dei minuti mancanti, crei periodi sintetici piatti che possono trarre in inganno gli indicatori. L'abitudine più sicura è misurare quanto è completo ogni bucket.
freq = interval
res = df.resample(freq).agg(OHLCV_AGG)
res["bar_count"] = df["close"].resample(freq).count()

expected = expected_count
res["is_partial"] = res["bar_count"] < expected * threshold
Ecco il flusso di lavoro che raccomandiamo:
- Calcola
bar_countcondf["close"].resample(freq).count(). - Determina il conteggio atteso per bucket, che corrisponde alla lunghezza del bucket in minuti per un mercato continuo e al numero corretto per sessione vicino alle aperture e chiusure.
- Segnala i bucket che scendono sotto una soglia scelta del conteggio atteso.
- Decidi caso per caso se eliminare o conservare le bar segnalate.
Il compromesso è semplice. Per i backtest, valuta di eliminare le bar parziali, perché una bar costruita solo da parte del suo intervallo atteso può sembrare più tranquilla di quanto il mercato fosse realmente. Per i grafici o certi input di machine learning, conserva la bar e porta avanti il flag is_partial come feature, così il modello o il lettore sa quanto fidarsene.
Suggerimento: Riporta le discrepanze per sessione, non solo per bucket. Un'intera sessione con sensibilmente meno bar rispetto alle vicine può indicare un problema di feed o di fuso orario, non un mercato tranquillo.
Il nostro audit per la gestione delle bar mancanti affronta la stessa idea dal lato della qualità dei dati.
Strategie di riempimento che mantengono logiche le candele OHLC
A volte devi riempire i gap, per un grafico live o per un modello che non può accettare buchi. Fallo colonna per colonna, mai con una singola chiamata generica. Un riferimento su asfreq nota che un forward o backward fill ingenuo produce valori di High e Low illogici, e raccomanda di ricostruirli a posteriori.
- Imposta un Open mancante dal Close precedente, dato che il primo trade di una nuova bar di solito apre vicino a dove è finito l'ultimo.
- Riempi un Close mancante dall'Open successivo, dove la bar successiva esiste.
- Fai forward-fill del volume solo se vuoi gestire gli zeri in modo esplicito. La maggior parte degli analisti imposta il volume mancante a 0.
- Ricostruisci High come
max(Open, Close)e Low comemin(Open, Close)per i bucket senza dettaglio tick.
filled = res.copy()
filled["open"] = filled["open"].fillna(filled["close"].shift())
filled["close"] = filled["close"].fillna(filled["open"].shift(-1))
filled["high"] = filled["high"].fillna(filled[["open", "close"]].max(axis=1))
filled["low"] = filled["low"].fillna(filled[["open", "close"]].min(axis=1))
filled["volume"] = filled["volume"].fillna(0)
Interpolare High e Low è rischioso perché può collocare un High sotto l'Open o un Low sopra il Close, cosa che nessuna candela reale può mostrare. Per saperne di più su come diverse scelte di costruzione delle bar cambiano ciò che un backtest vede, leggi il nostro articolo sui metodi di aggregazione delle bar.
Come label e closed cambiano il contenuto dei bucket
Due parametri decidono cosa contiene ogni bucket e come viene etichettato. La guida sulle serie temporali dimostra entrambi con esempi come ts.resample('2h').mean().
closed="left"include il bordo sinistro dell'intervallo ed esclude quello destro, quindi una riga delle 09:35:00 appartiene al bucket delle 09:35.closed="right"inverte questo comportamento, e la riga delle 09:35:00 finisce nel bucket che termina alle 09:35.label="left"etichetta il risultato con l'inizio dell'intervallo.label="right"lo etichetta con la fine, quindi una bar da 09:30 a 09:35 viene etichettata 09:35.- Una riga che cade esattamente su un confine è il caso in cui queste impostazioni cambiano i tuoi numeri, non solo le etichette, perché la riga si sposta in un bucket diverso e altera open, close e volume.
- Se le tue bar al minuto sono timbrate all'apertura, usa
closed="left", label="left". Se sono timbrate alla chiusura,closed="right", label="right"di solito corrisponde al significato dei dati.
Imposta entrambi i parametri in modo esplicito nel codice di ricerca invece di fidarti dei valori predefiniti, e scrivi un commento di una riga che indichi quale convenzione di timbratura usa la tua fonte. Il te stesso futuro ti ringrazierà.
Checklist pre-volo prima di fare il backtest delle bar risultanti dal resampling
Esegui questi controlli prima che le bar risultanti dal resampling entrino in qualsiasi sistema di ricerca o live:
- Verifica i conteggi attesi di minuti per sessione e segnala le discrepanze.
- Conferma la gestione del fuso orario e del DST, e ispeziona la prima e l'ultima bar parziale di ogni giorno.
- Controlla
bar_count, poi elimina o segnala le bar con conteggio basso. - Evita il forward-fill cieco dell'OHLC.
- Usa solo bar completate per i segnali, spostando di una bar dove necessario, così un segnale non vede mai una bar che non si è ancora chiusa.
| Controllo | Azione in caso di fallimento |
|---|---|
| Conteggio minuti per sessione | Indaga sul feed o sul fuso orario prima del resampling |
| Prima o ultima bar parziale | Eliminala o segnalala con is_partial |
bar_count basso | Elimina per i backtest, conserva e segnala per i grafici |
| OHLC riempito | Ricostruisci High e Low da Open e Close |
| Tempistica dei segnali | Sposta in modo che i segnali usino solo bar completate |
Il nostro spike test per la pulizia dei dati intraday si abbina bene a questa lista, perché i tick anomali distorcono gli high e low aggregati.
Esempio completo: da 1min a 5min, 15min e 1h con gestione dei dati parziali
Ecco uno schema eseguibile che combina tutto quanto visto sopra:
frames = {}
for rule, n in {"5min": 5, "15min": 15, "1h": 60}.items():
    out = df.resample(rule).agg(OHLCV_AGG)
    out["bar_count"] = df["close"].resample(rule).count()
    out["is_partial"] = out["bar_count"] < n * 0.8
    frames[rule] = out[~out["is_partial"]].dropna(subset=["close"])
Procedi in quest'ordine:
- Parti da un DataFrame al minuto con un DatetimeIndex ordinato e localizzato.
- Fai il resampling alle frequenze desiderate con lo stesso
OHLCV_AGG. - Calcola
bar_count, impostais_partialusando una soglia scelta, ed elimina le bar segnalate. - Verifica: confronta il volume totale prima e dopo (dovrebbero corrispondere a parte le bar eliminate), poi scegli alcuni bucket e ricalcola a mano open, high, low e close dalle righe grezze.
Suggerimento: Controlla a campione la prima bar della giornata e la bar successiva a qualsiasi gap noto. È lì che si nascondono i bug di allineamento.
Perché conserviamo i minuti grezzi e facciamo il resampling più tardi
Il nostro punto di vista è che dovresti conservare i dati al minuto anche se la tua strategia opera su bar orarie. I dati al minuto sono essenziali per la modellazione della microstruttura e dello slippage, e conservarli significa poter rifare il resampling con un allineamento corretto quando scopri un errore di fuso orario o di origin. Il costo è lo storage e l'IO, che è piccolo rispetto al costo di un backtest costruito su bar che non puoi ricostruire. Bar più grossolane vanno bene per strategie di livello più alto, ma derivale da una fonte al minuto verificata, non il contrario. Fonti pulite riducono anche le sorprese dovute a bar mancanti e timestamp incoerenti, che rendono ogni controllo a valle più difficile.
— Start
Bar al minuto pronte all'importazione da BacktestMarket
Se preferisci partire da bar verificate piuttosto che controllare i tuoi dati da solo, offriamo dataset intraday di bar al minuto puliti, pronti per l'importazione in MT4 e MT5. Ogni bar è verificata. Sfoglia i nostri Dati Storici oppure consulta il Piano Annuale, listato a 119 EUR all'anno.
FAQ
Qual è il modo corretto di fare il resampling dei dati al minuto in bar a 5 minuti?
Usa df.resample("5min").agg(OHLCV_AGG) con open come first, high come max, low come min, close come last e volume come sum. Poi elimina i bucket vuoti con dropna(subset=["close"]). La documentazione di pandas elenca questo stile di aggregazione per i dati OHLCV.
Dovrei fare forward-fill dei minuti mancanti prima del resampling?
Di solito no per i backtest. Il forward-fill crea bar sintetiche piatte che possono far sembrare un mercato più tranquillo di quanto fosse realmente. Conta le righe reali per bucket ed elimina o segnala quelle scarse invece di riempirle.
Come faccio a far iniziare le bar risultanti dal resampling sui confini della sessione?
Localizza nel fuso orario dell'exchange, poi imposta origin o offset in modo che la griglia inizi all'apertura della sessione. Per i dati in epoch, uno snap modulo sul timestamp dà la stessa griglia fissa senza dipendere dall'origin.
Cosa fa label="right" nel resample?
Etichetta ogni bar con la fine del suo intervallo invece che con l'inizio. Combinalo con closed="right" quando le tue bar al minuto sono timbrate alla chiusura, così le righe sui confini finiscono nel bucket a cui appartengono.
Consigliati
- Quattro Fonti di Dati Forex al Minuto per Quant Pronte per MT4/MT5
- Quant: Pulizia dei Dati Intraday con uno Spike Test a Tre Condizioni
- Fermate i Backtest Falsi: 3 Controlli QA per Dataset Pronti all'Importazione MT4/MT5
- Sei Metodi di Aggregazione delle Bar che i Quant Possono Calibrare per i Backtest ML
Risorse correlate
Esplora i robot Expert Advisor di BacktestMarket per mettere in pratica le idee di questo articolo.